Simplex-LP-Solver-Suite
Ein Python-Toolkit für lineare Optimierung (LP): ein Zwei-Phasen-Simplex-Solver mit Schritt-für-Schritt-Tableaus, 2D-/3D-Visualisierungen, Sensitivitätsanalyse und einer natürlichsprachlichen Schnittstelle auf Basis eines LLM.
Problem
Die meisten LP-Solver sind Blackboxes: Sie liefern ein Optimum, zeigen aber weder, wie der Algorithmus dorthin gelangt, noch, wie empfindlich die Lösung auf die Eingabedaten reagiert.
Ansatz
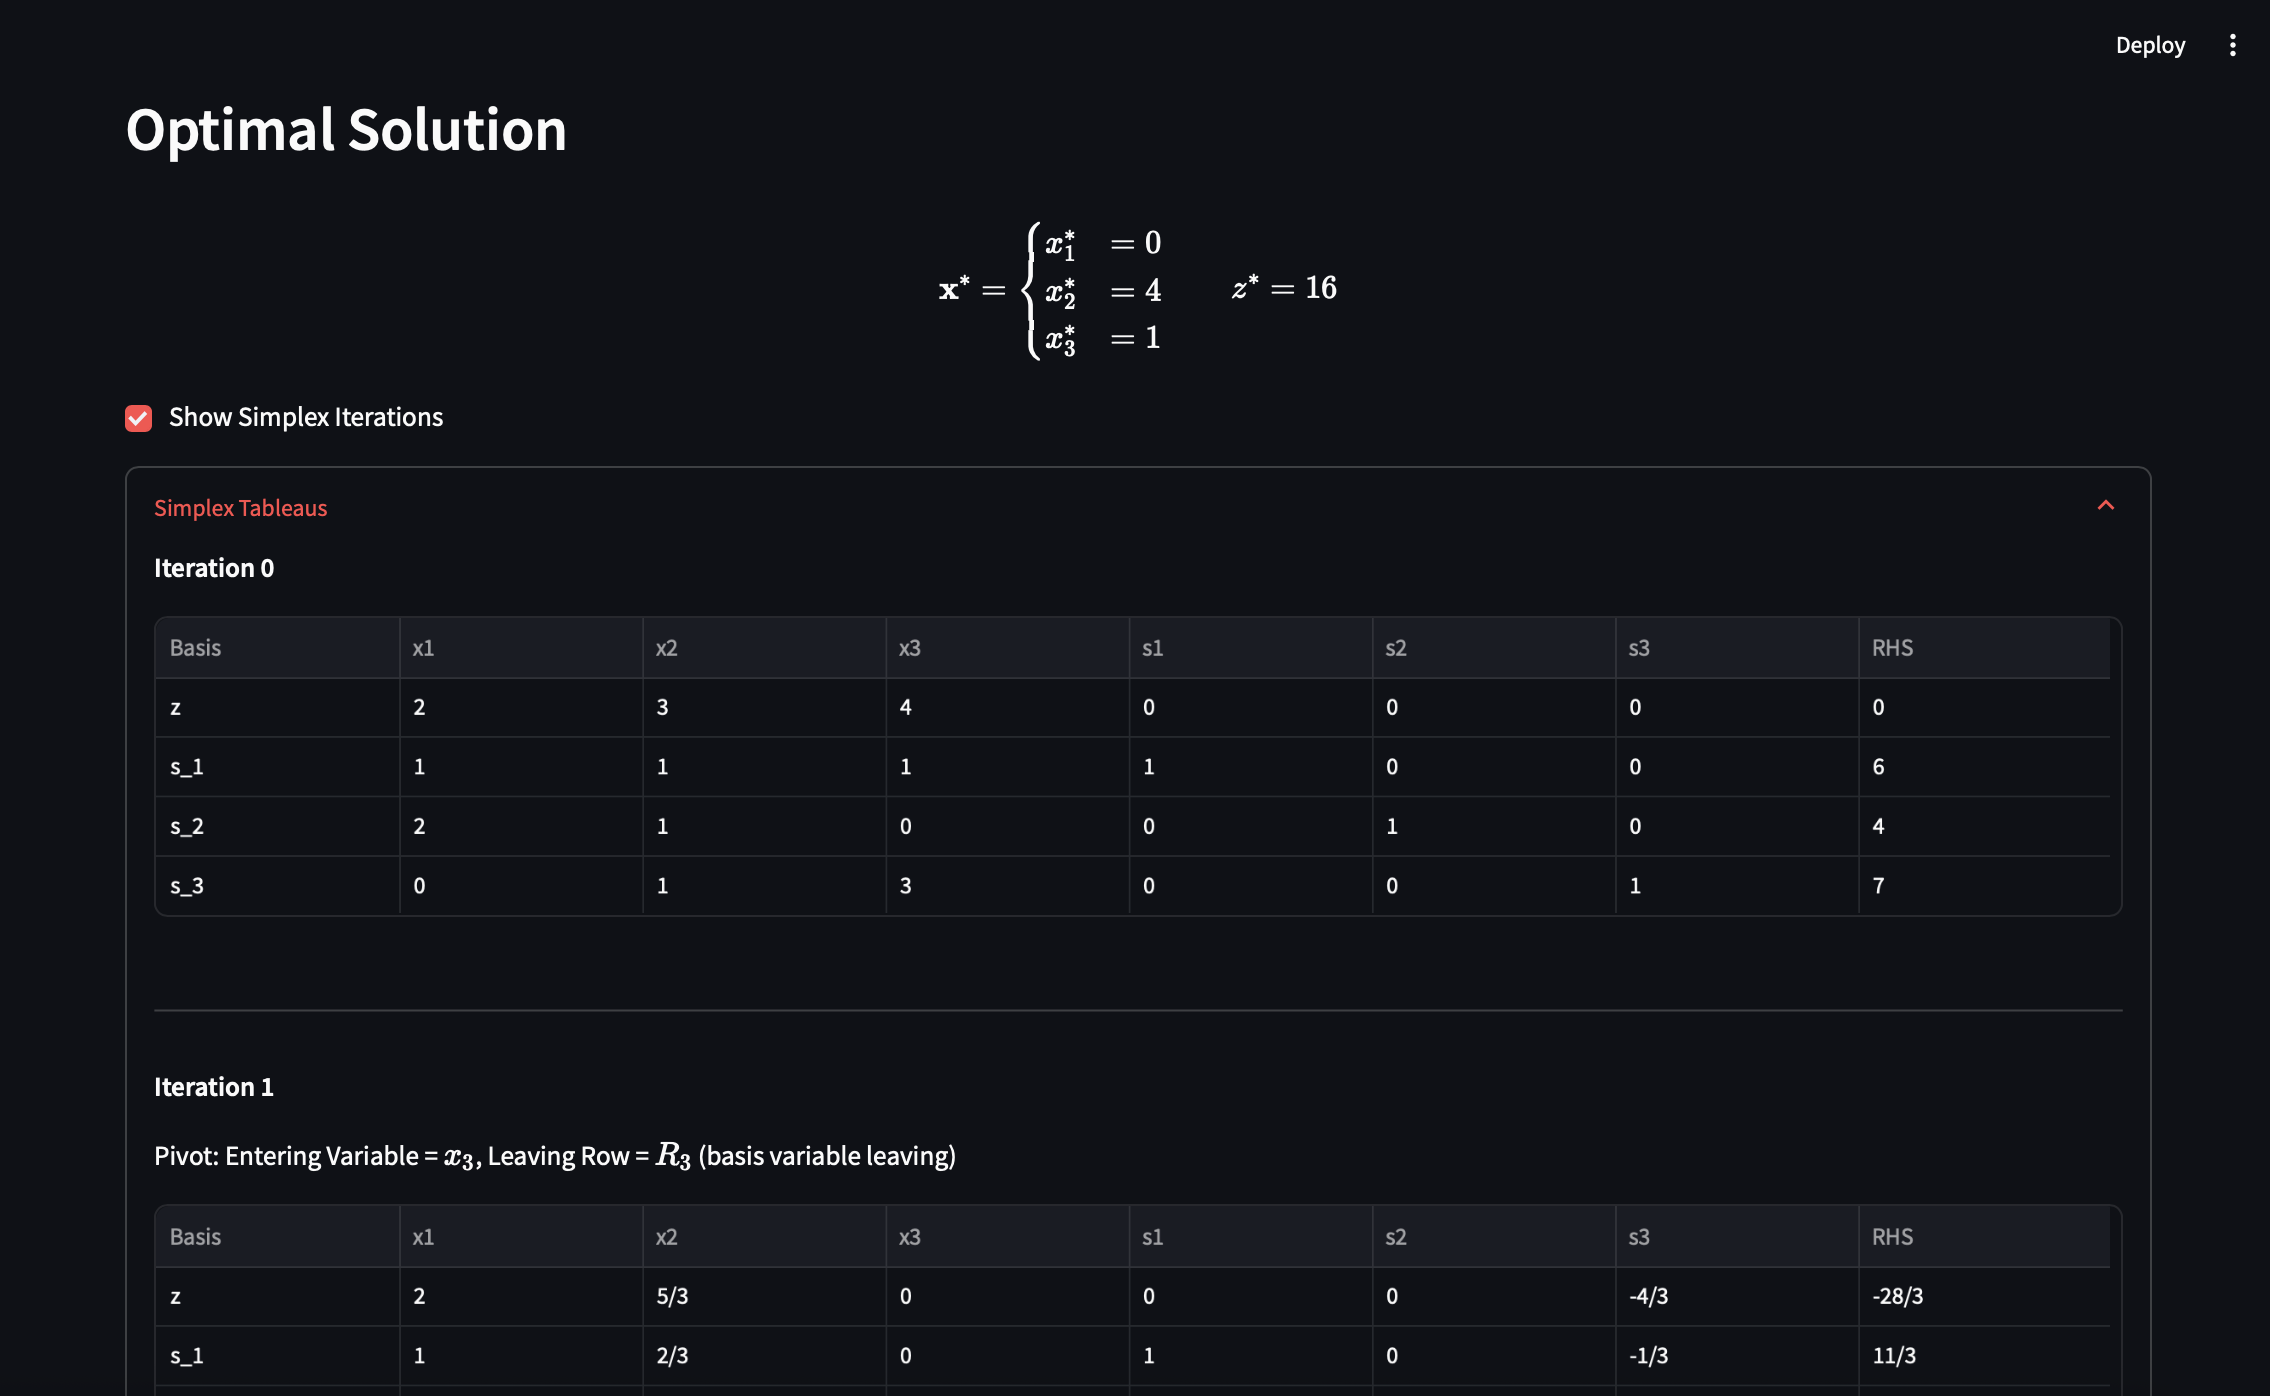
Ich habe das primale Zwei-Phasen-Simplexverfahren mit optionaler exakter Arithmetik implementiert, dazu eine Streamlit-Oberfläche, die jeden Pivotschritt zeigt, eine Sensitivitätsanalyse mit Schattenpreisen und zulässigen Bereichen sowie eine LLM-Seite, die in Alltagssprache formulierte Probleme in lösbare LPs übersetzt.
Ergebnis
Die Ergebnisse des Solvers werden in einer Unit-Test-Suite gegen den HiGHS-Solver von SciPy validiert – für zulässige, unzulässige und unbeschränkte Probleme sowie für Probleme mit Gleichheitsnebenbedingungen.
Überblick
Dieses Projekt ist eine vollständige Solver-Suite für lineare Optimierung (LP), entwickelt in Python. Ich habe sowohl den klassischen primalen Zwei-Phasen-Simplex-Algorithmus als auch Karmarkars Innere-Punkte-Verfahren implementiert (Letzteres ist allerdings noch nicht vollständig in die Oberfläche eingebunden). Ziel war es, flexibel ein breites Spektrum an LP-Problemen lösen zu können und den Lösungsprozess dabei transparenter und interaktiver zu machen – statt einer reinen Blackbox.
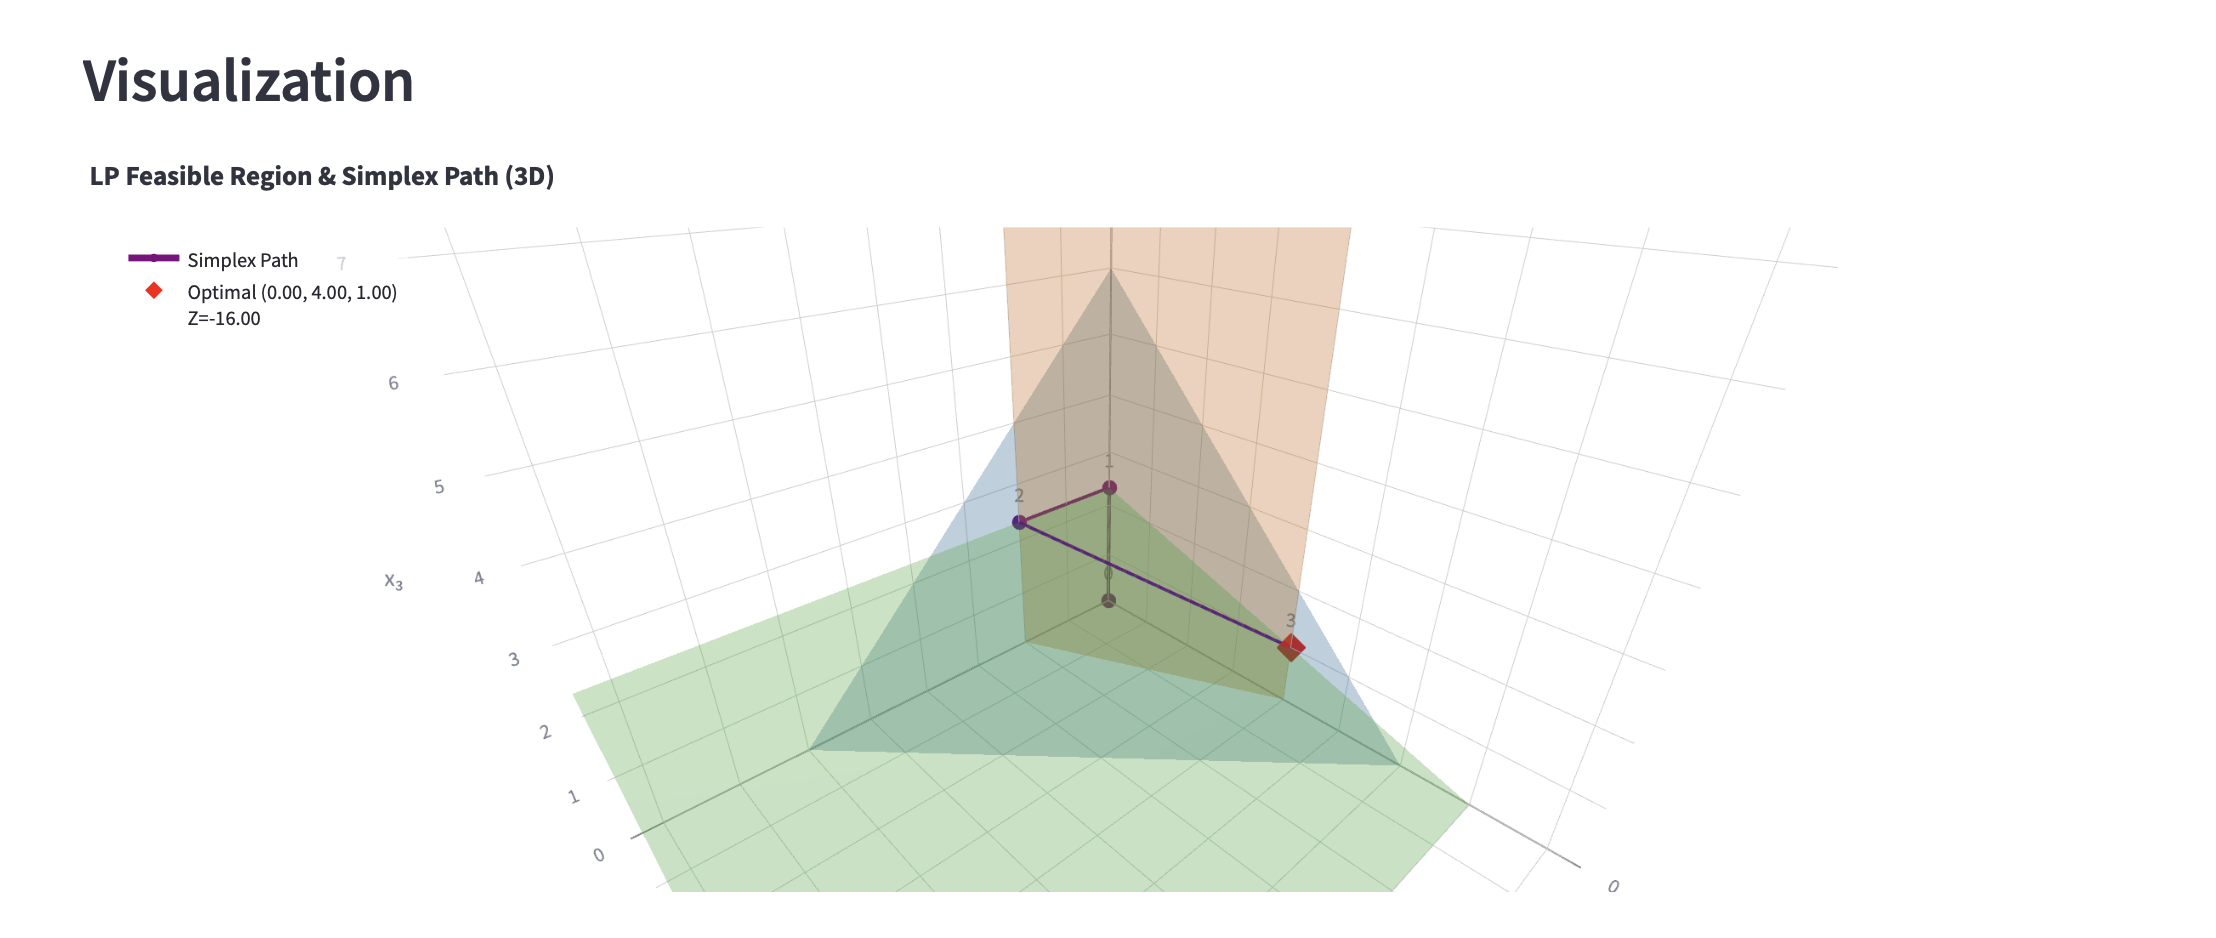
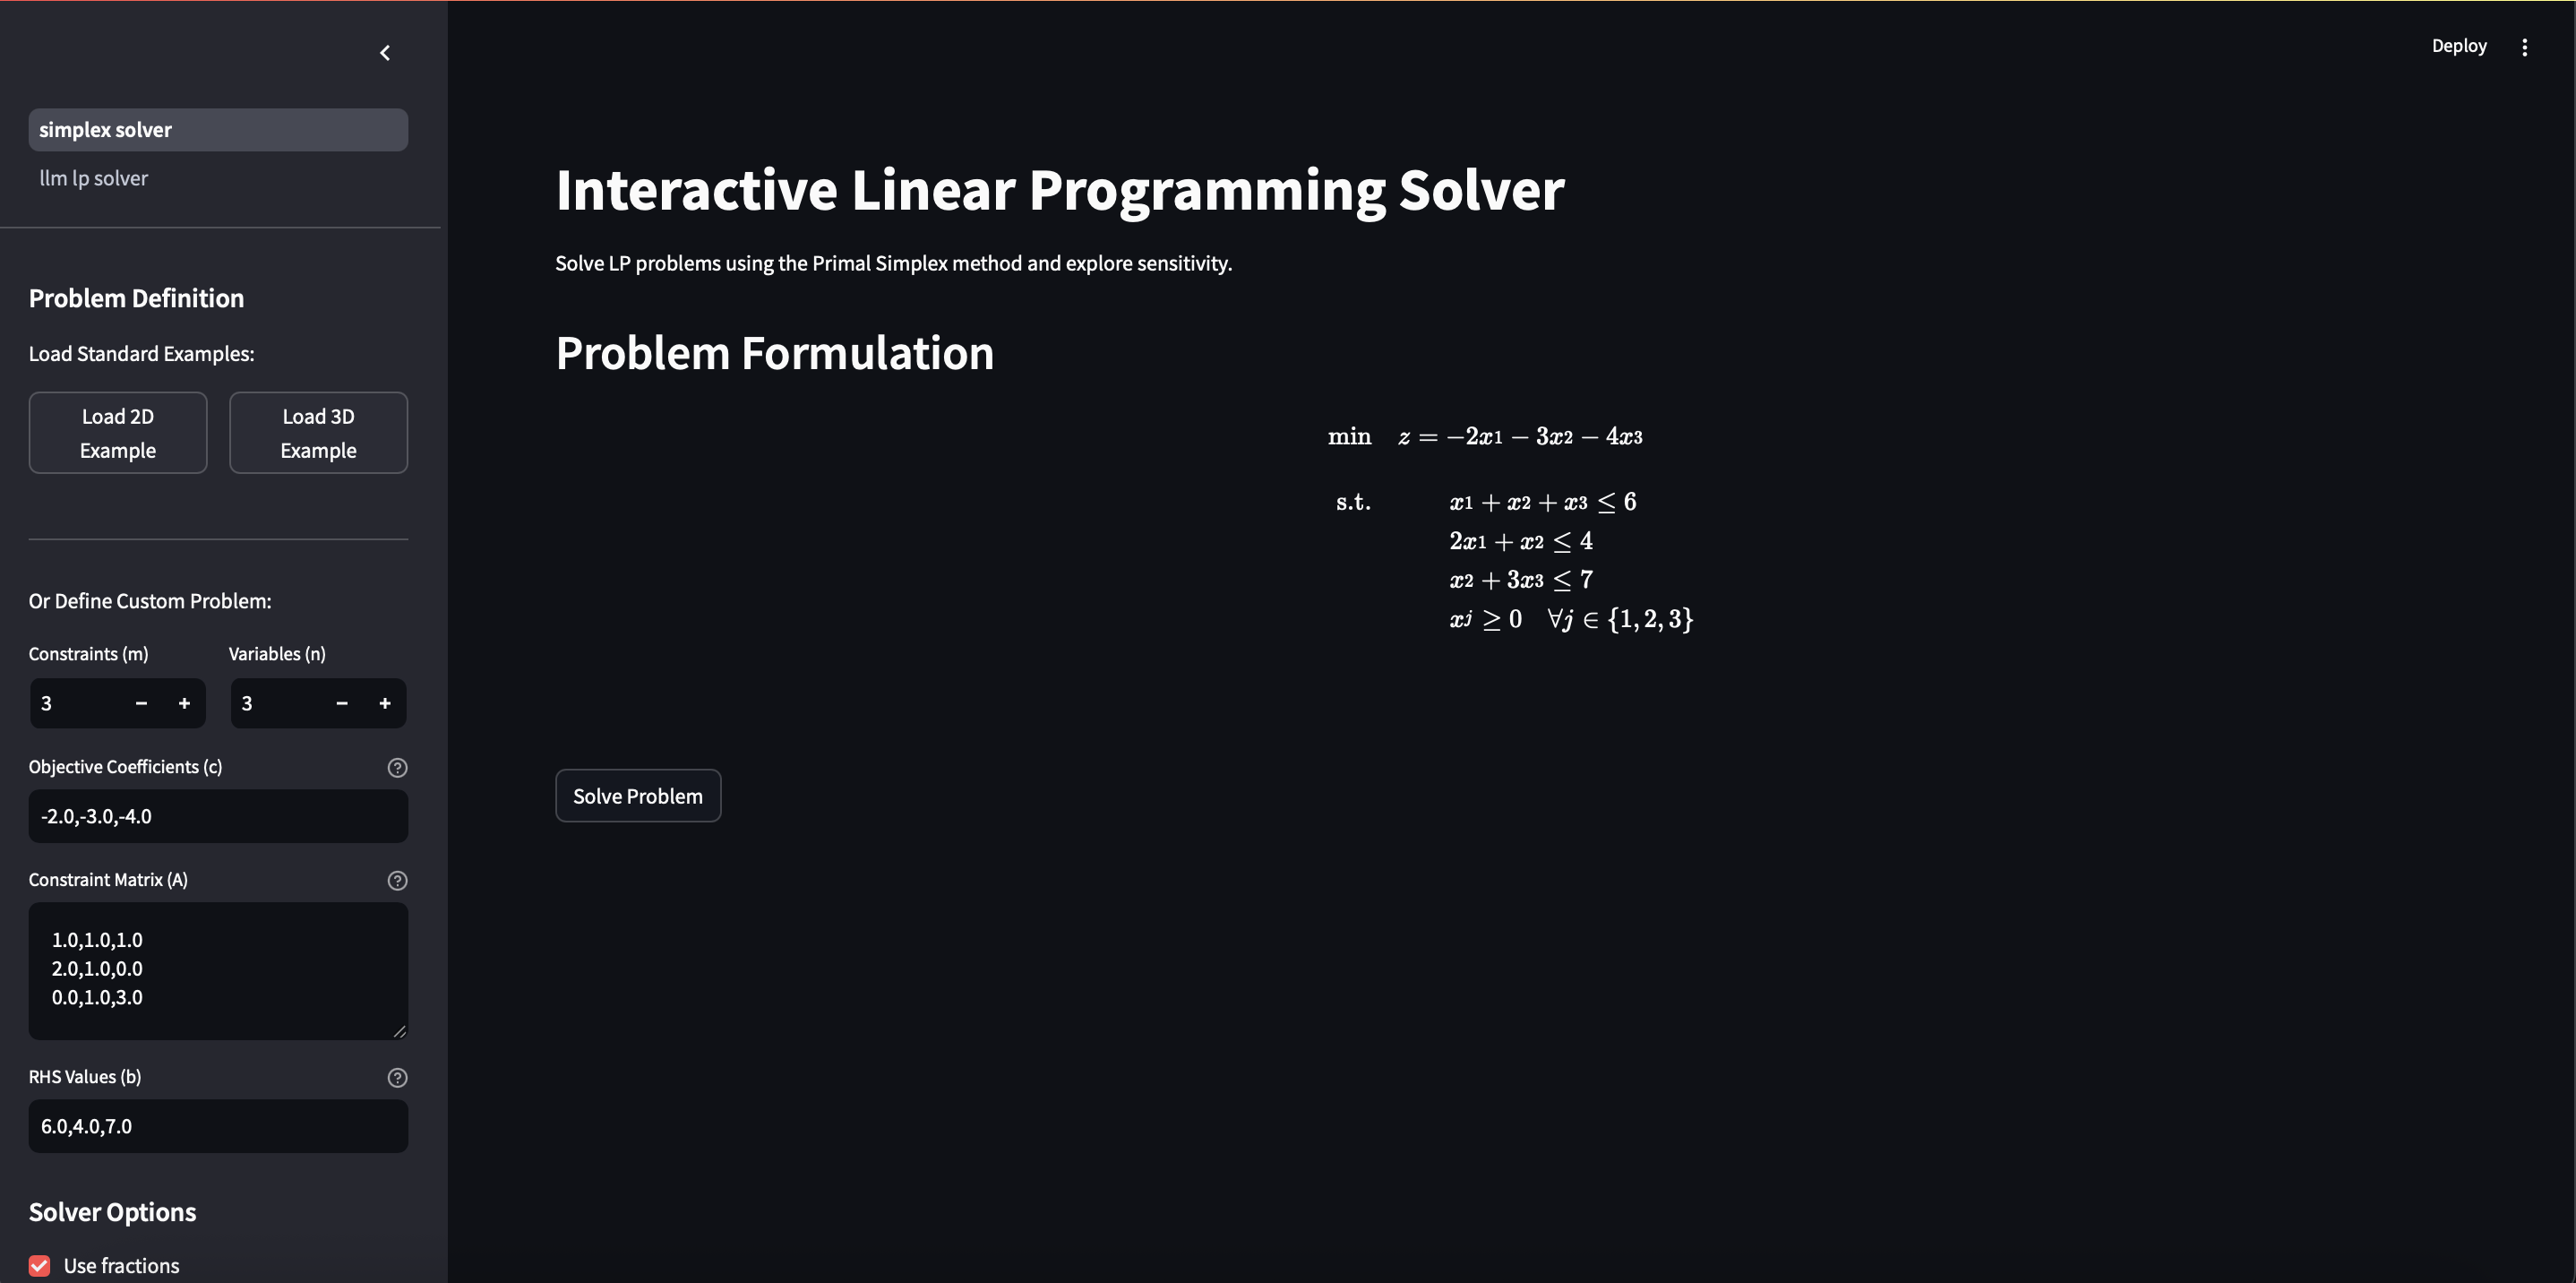
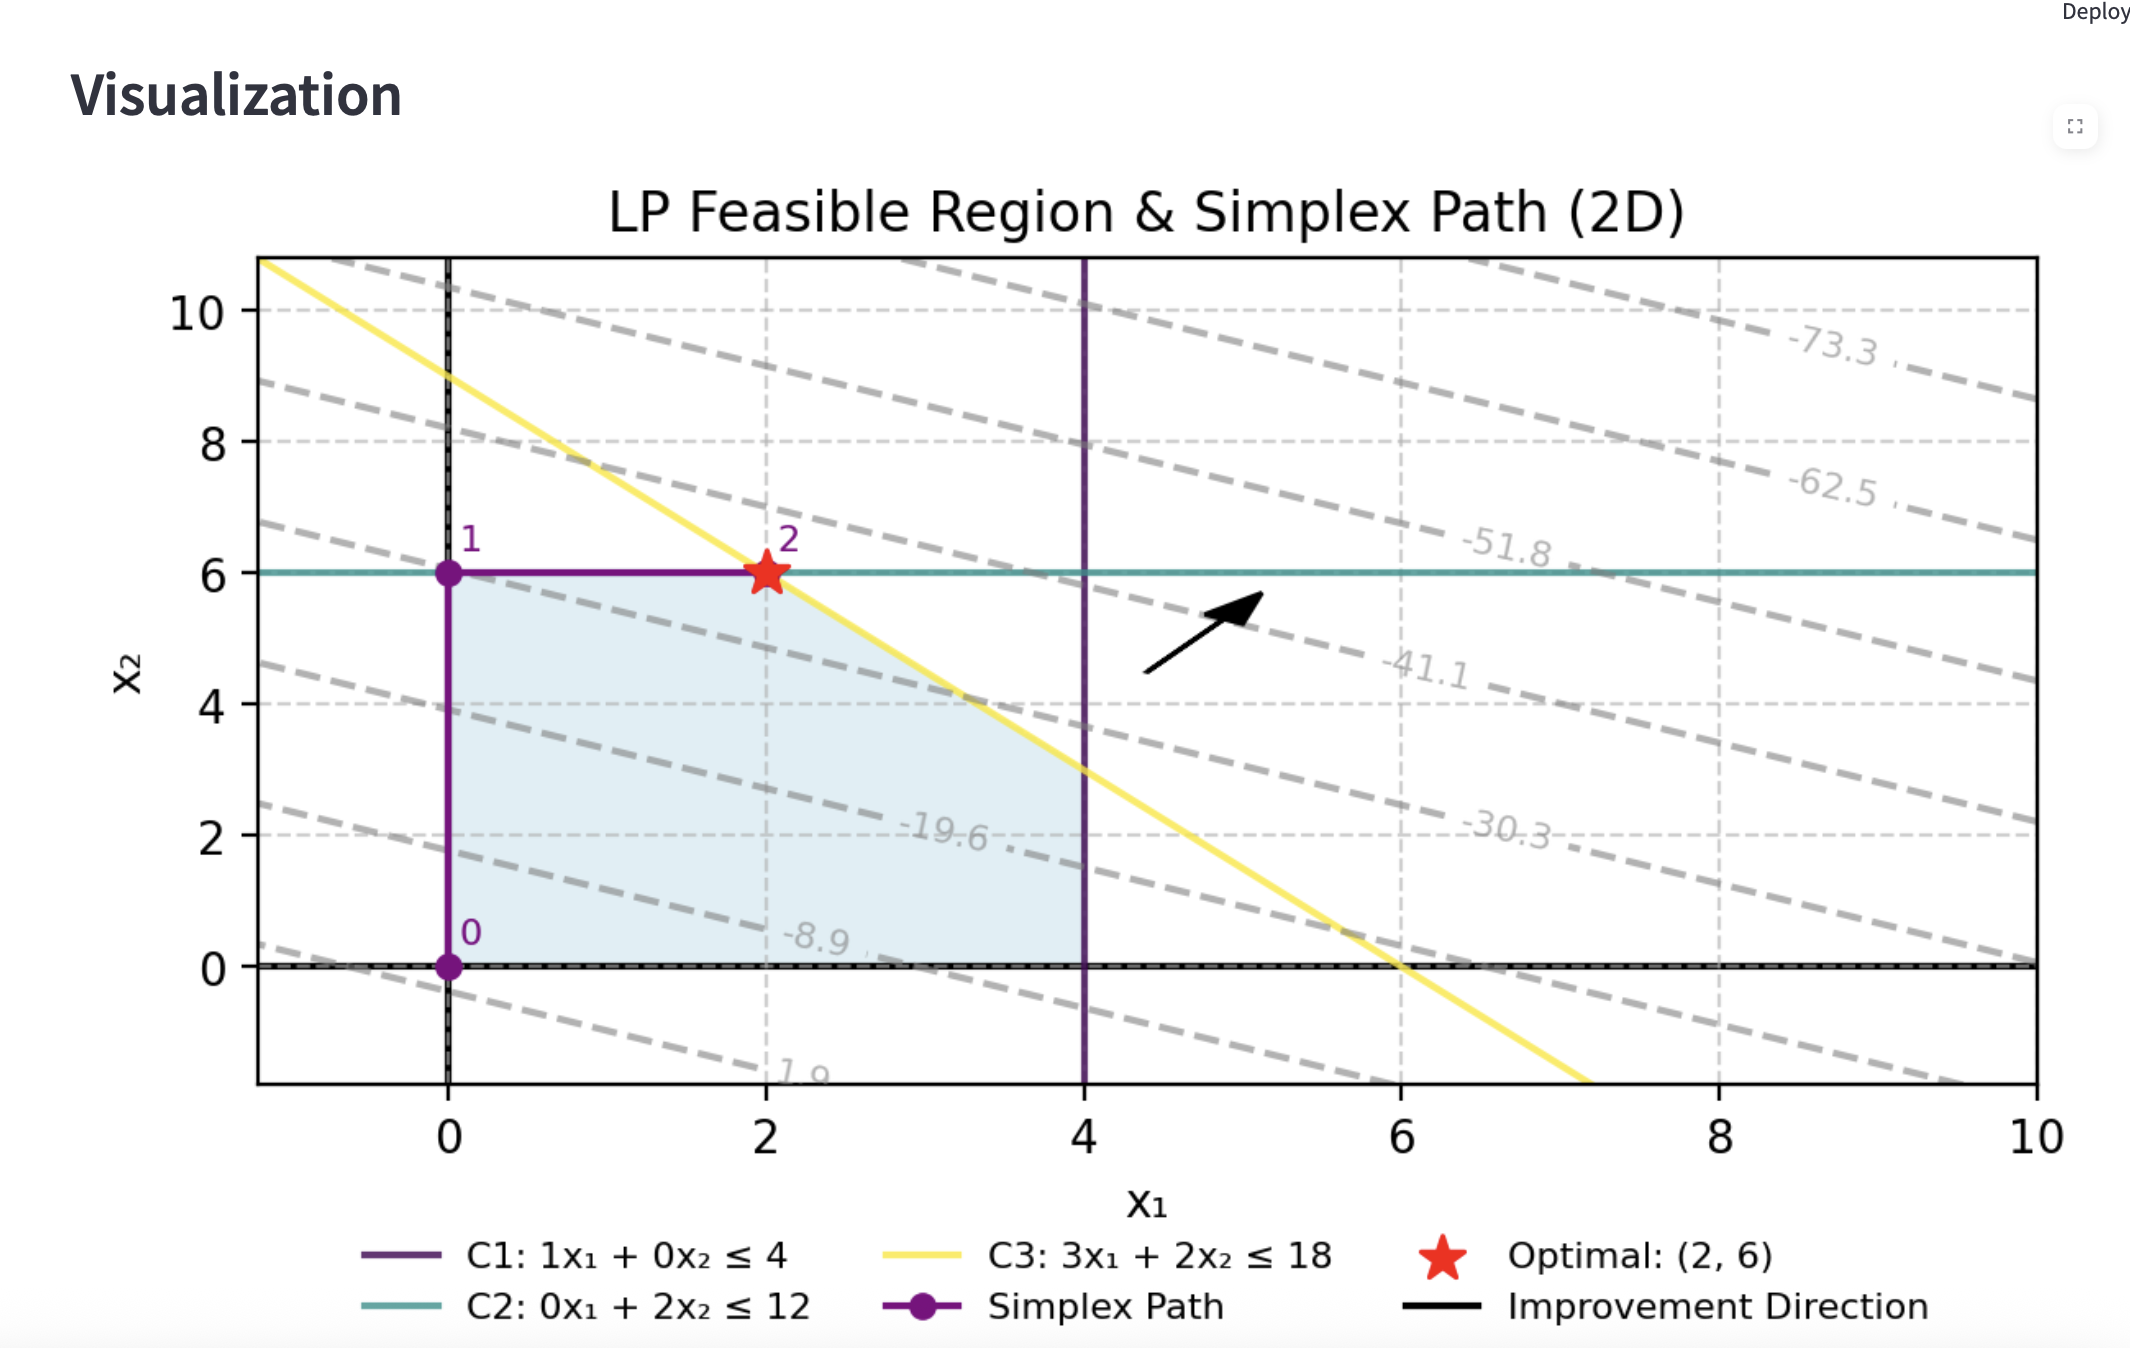
Zur Suite gehört eine Streamlit-Weboberfläche, die jeden Pivotschritt des Simplexverfahrens visualisiert. Nutzer können zwischen Gleitkomma- und exakter Arithmetik (über Pythons fractions-Modul) wechseln, um Rundungsprobleme zu reduzieren. Außerdem lassen sich zulässige Bereiche in 2D/3D visualisieren, und die Problemstellungen werden zur besseren Übersicht mit LaTeX dargestellt.
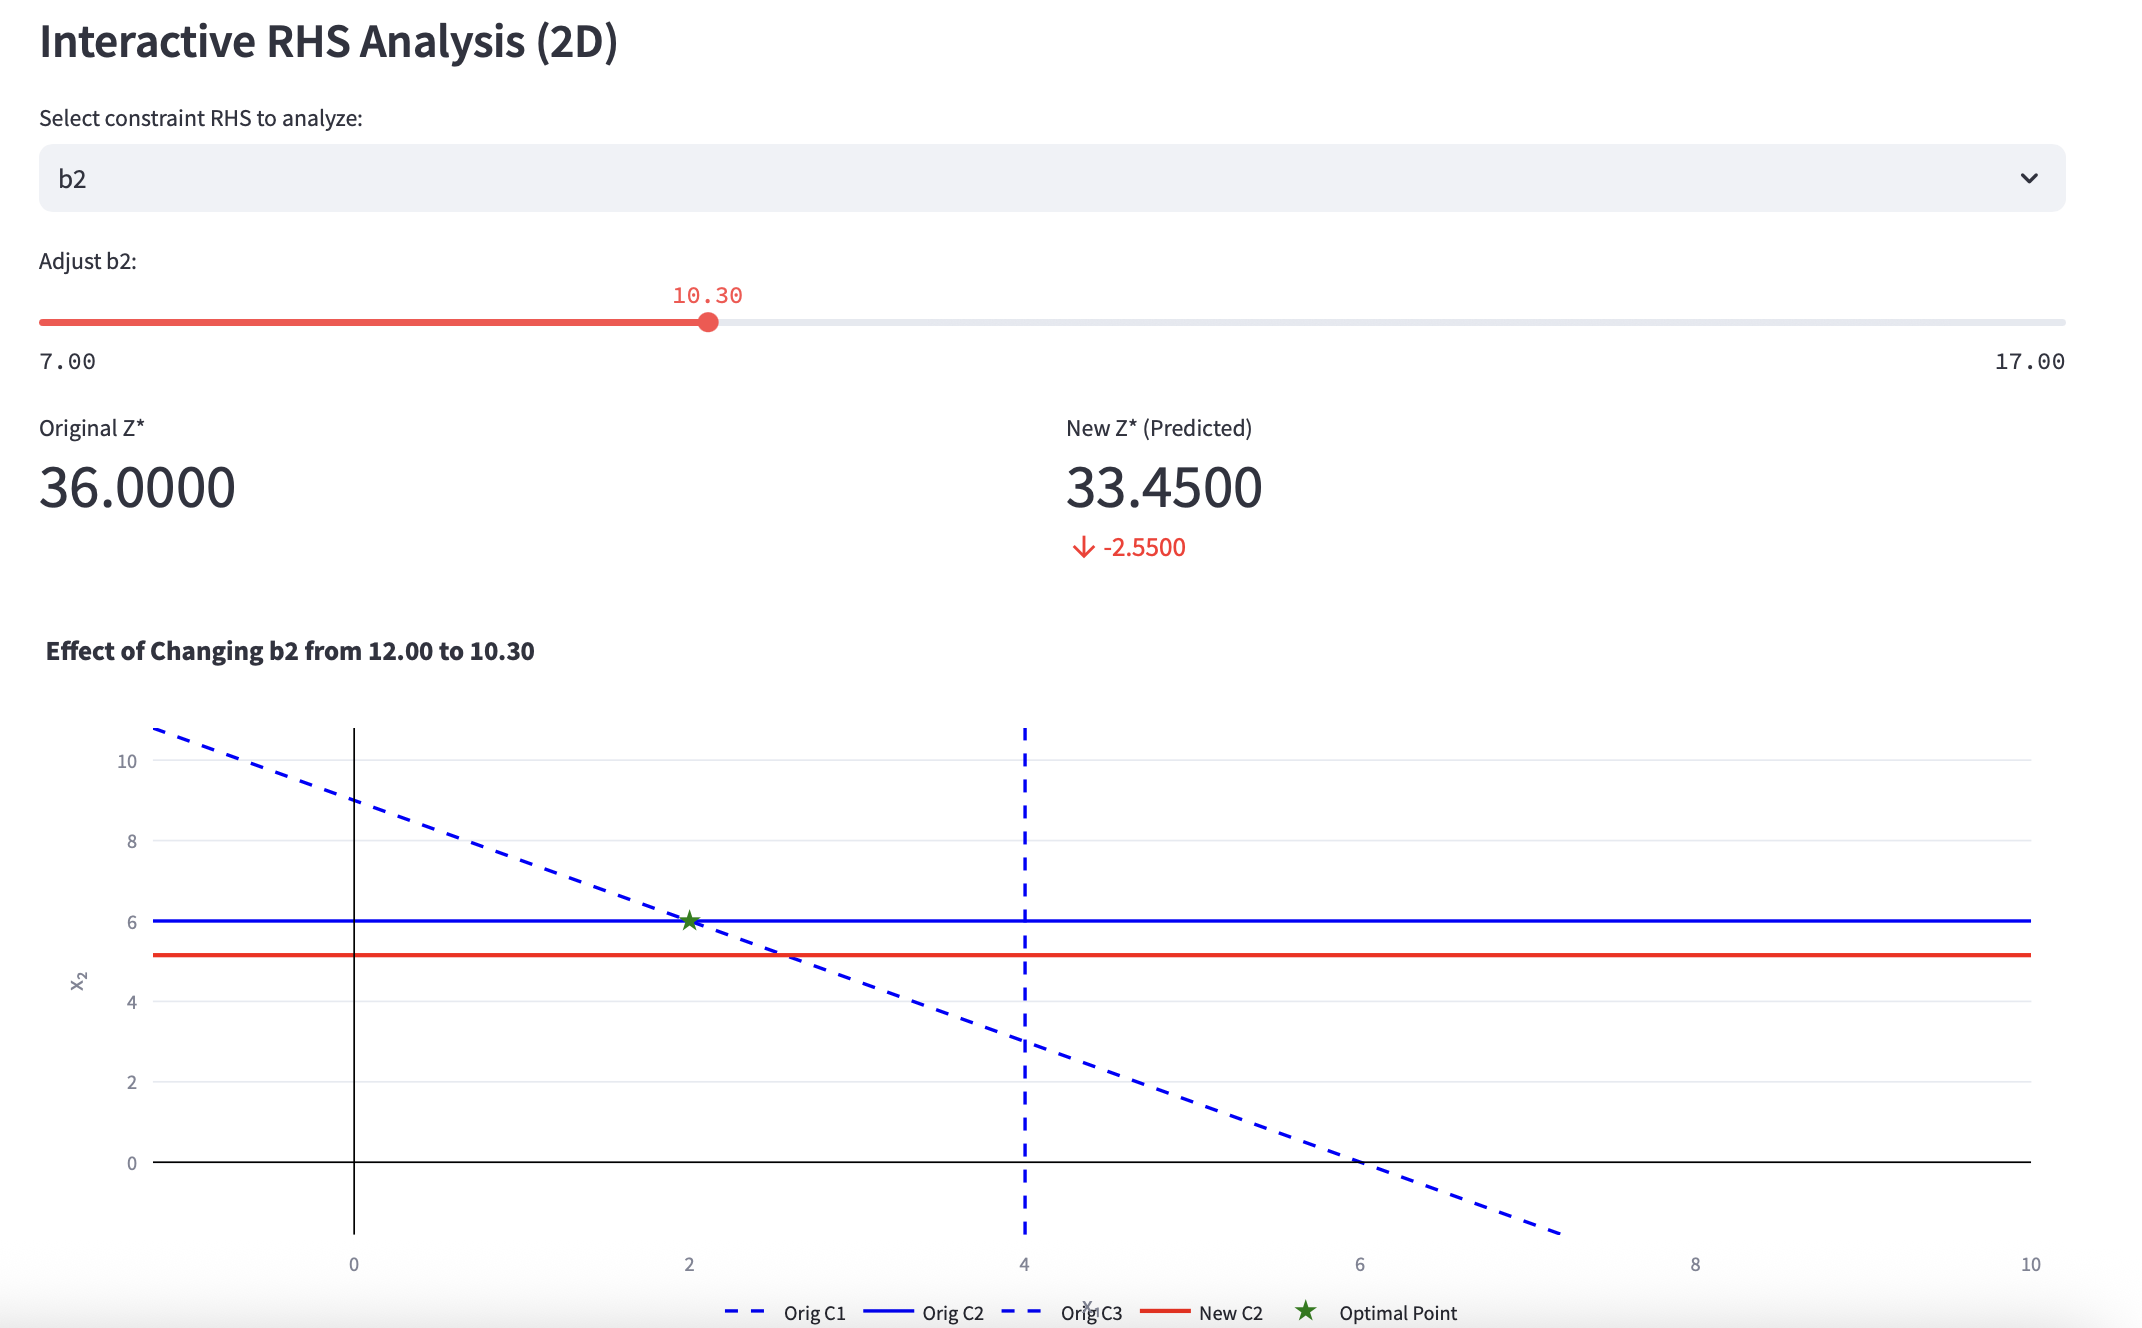
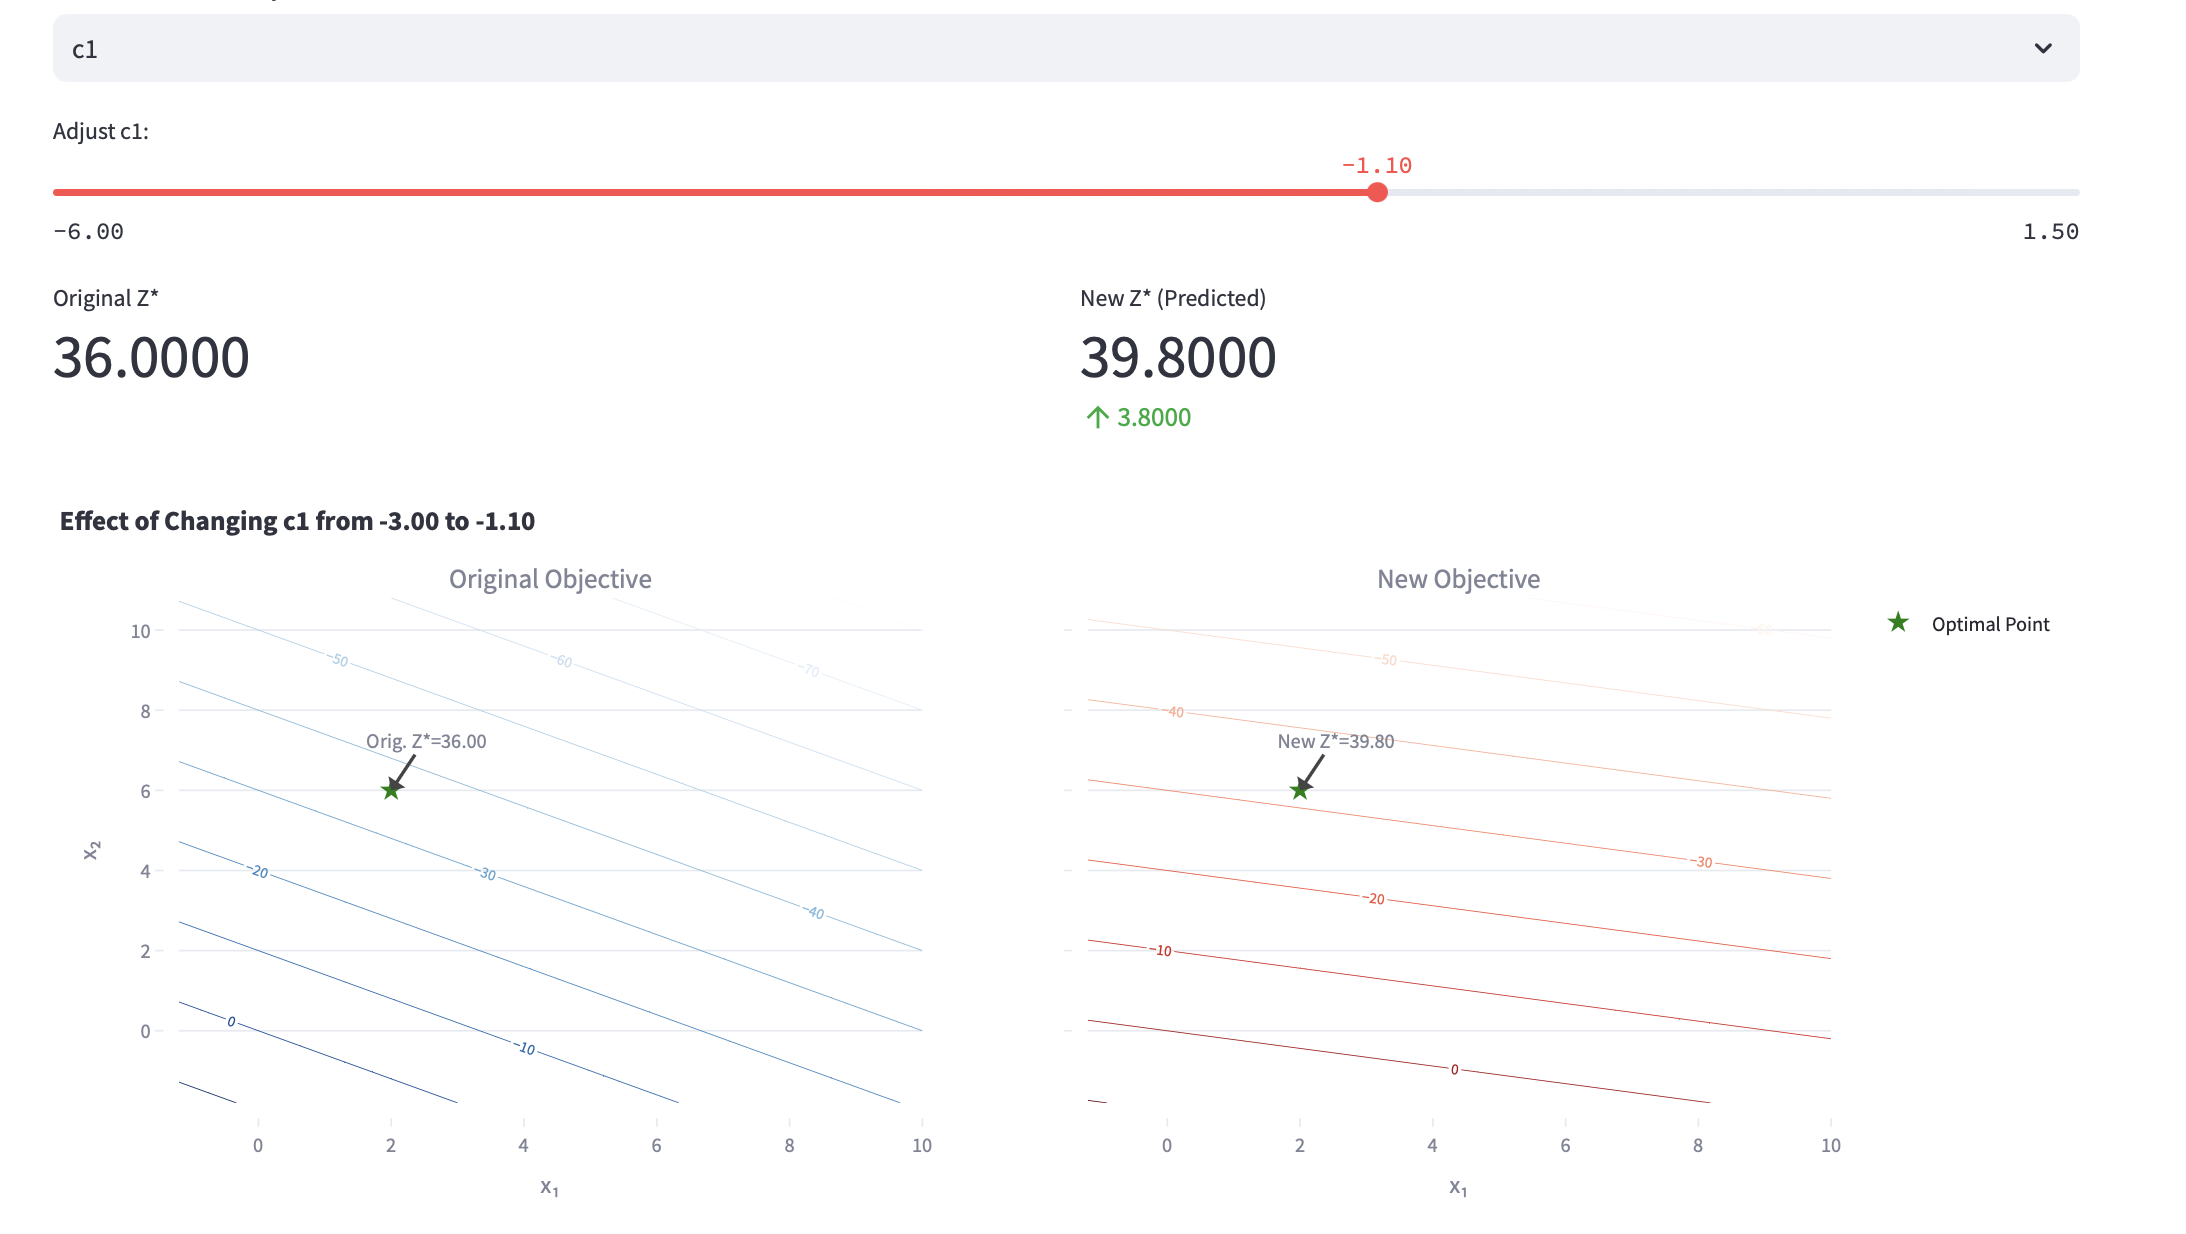
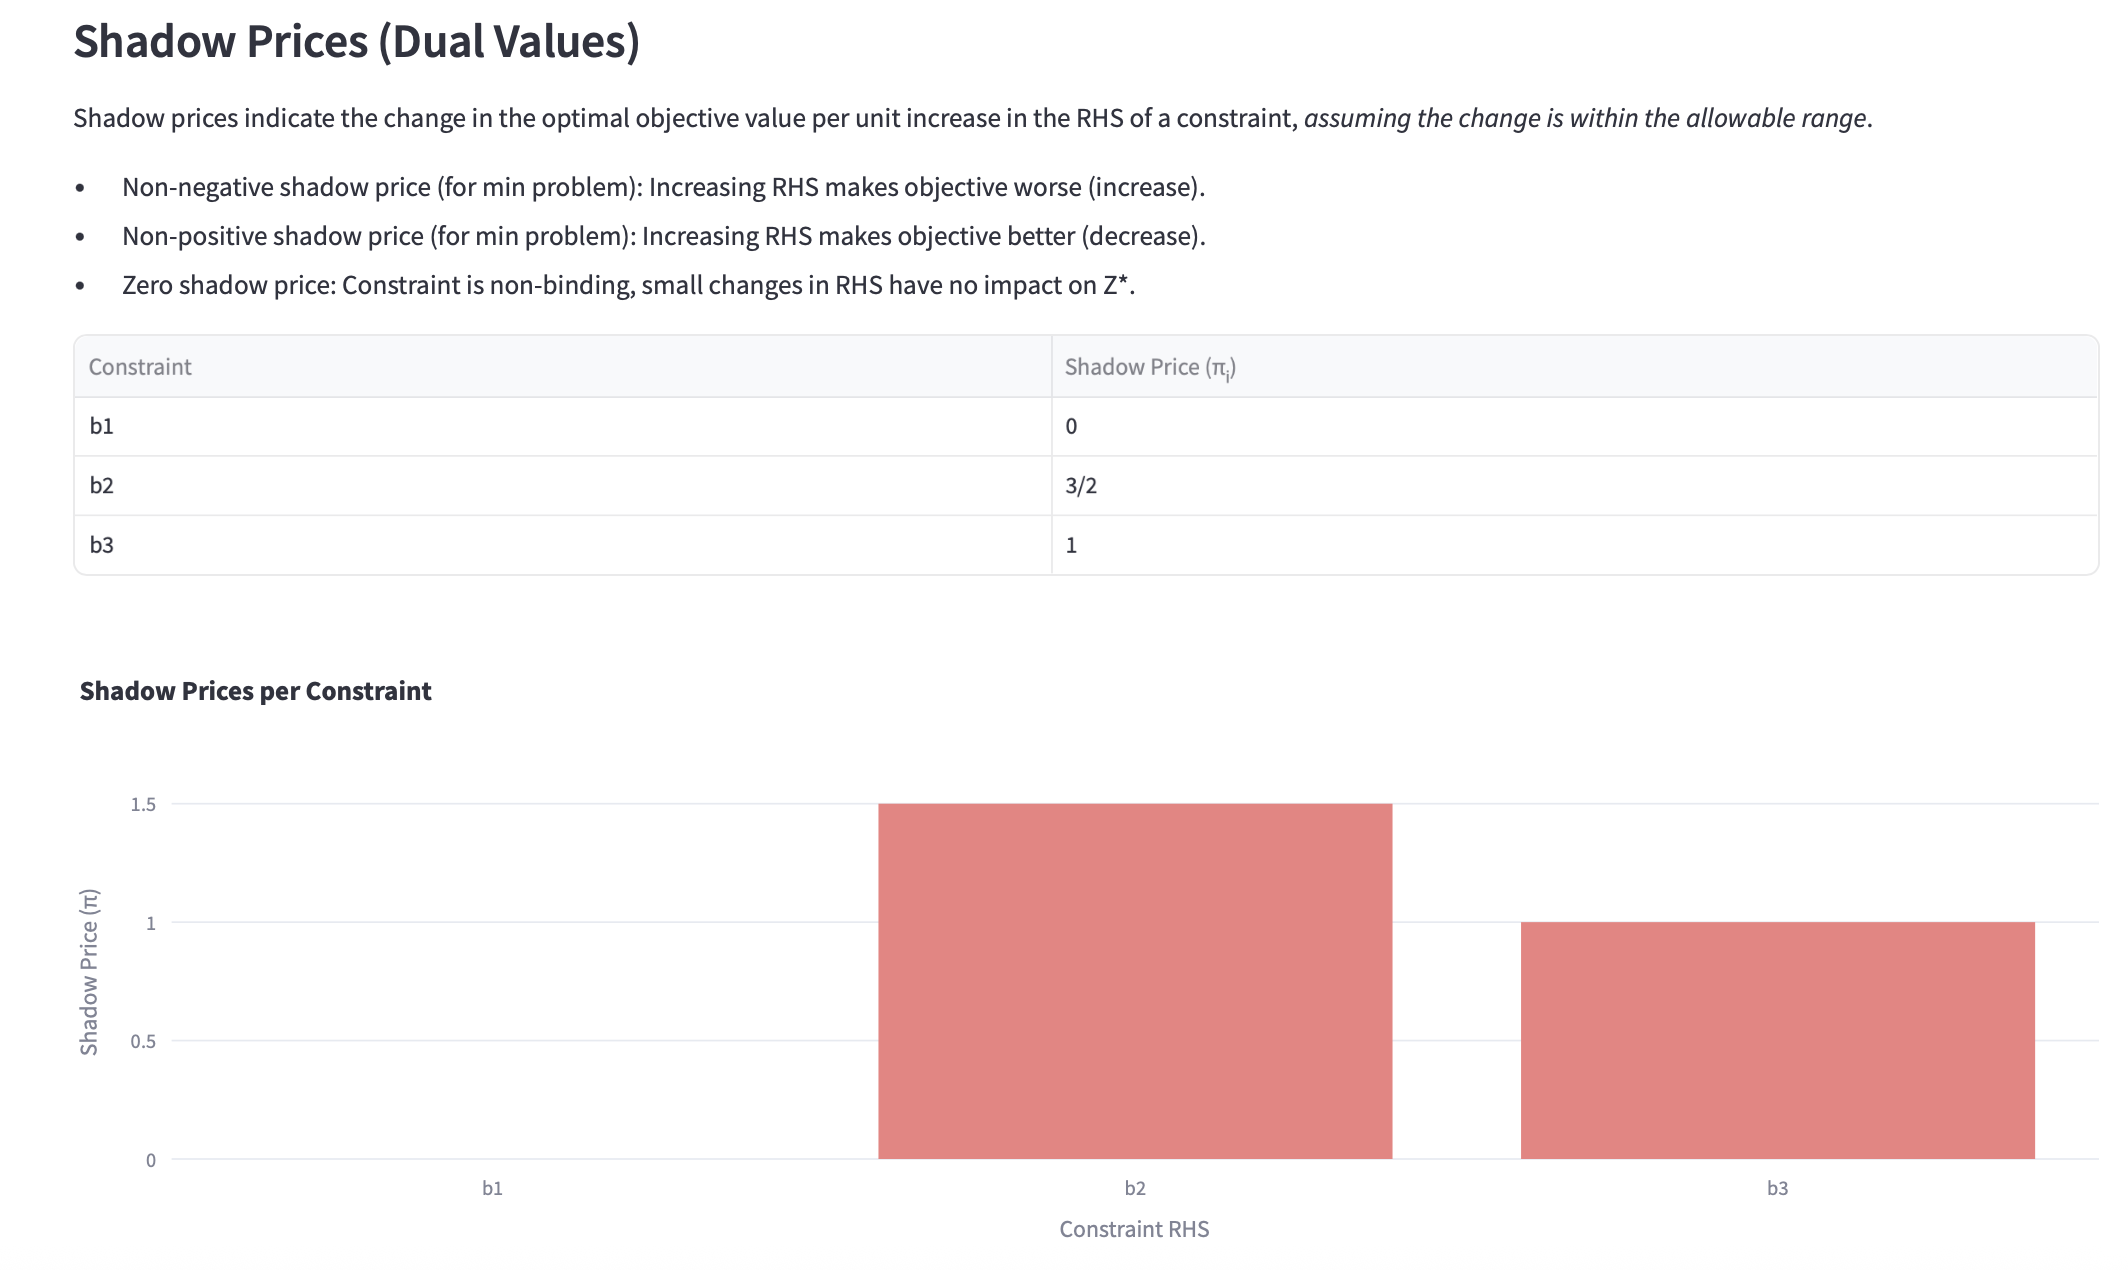
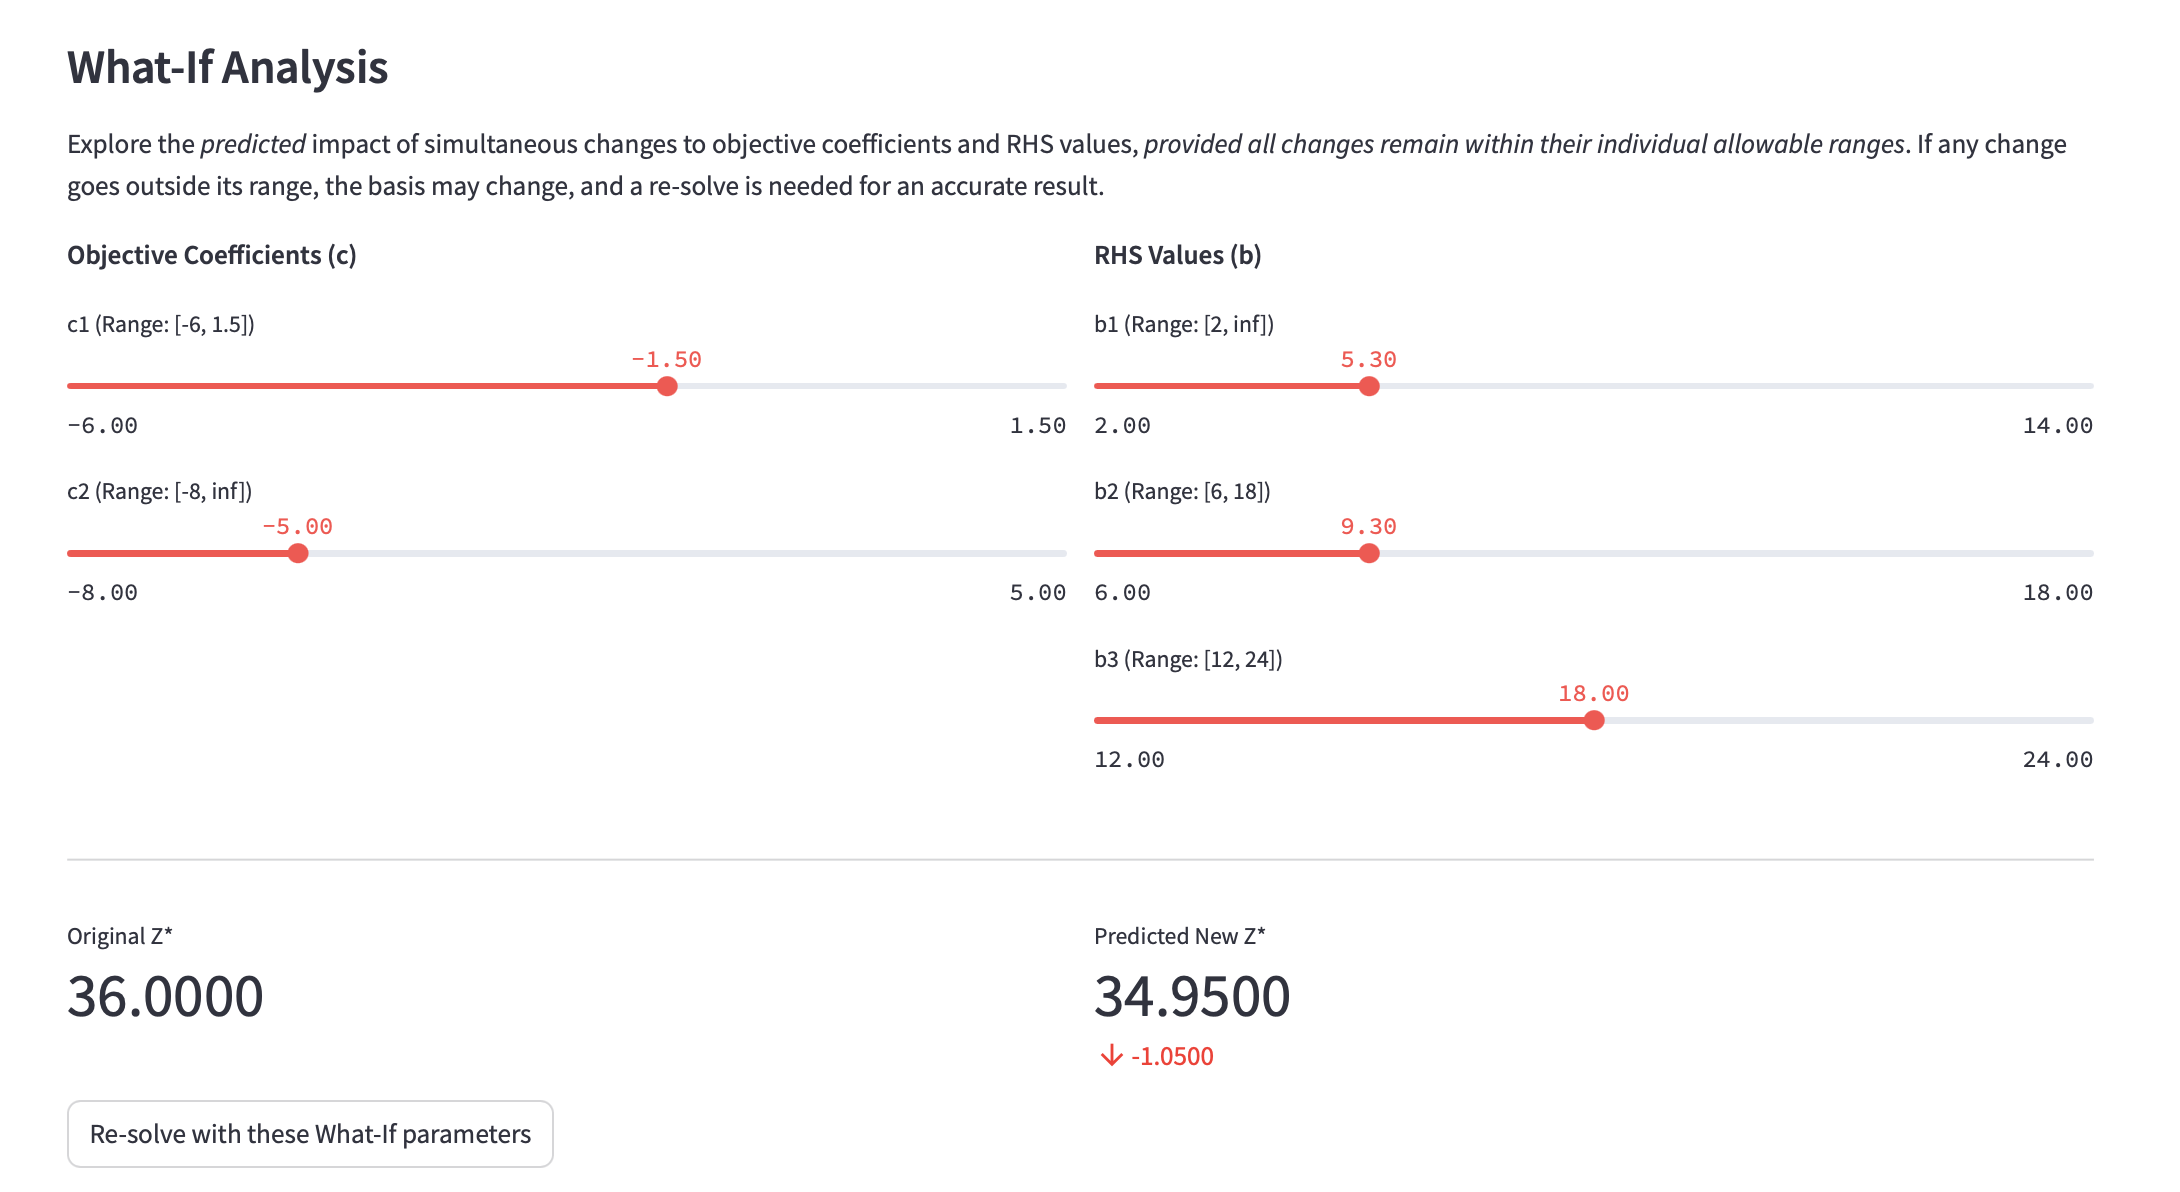
Über die eigentlichen Solver hinaus habe ich ein Modul für Sensitivitätsanalyse entwickelt, mit dem Nutzer sehen, wie sich Änderungen an den Koeffizienten der Zielfunktion oder an den Schranken der Nebenbedingungen auf die optimale Lösung auswirken. Es berechnet Schattenpreise und zulässige Bereiche und bietet interaktive Schieberegler, die die Diagramme in Echtzeit aktualisieren.
Ein weiteres zentrales Feature ist die Seite „LLM LP Solver“ – eine natürlichsprachliche Schnittstelle, die mit Google Gemini in Alltagssprache verfasste Problembeschreibungen in strukturierte LPs umwandelt. Sie erzeugt automatisch den passenden scipy.optimize.linprog-Code, führt ihn aus und interpretiert die Ergebnisse. Damit wollte ich LPs vor allem zugänglicher machen, auch für Nutzer ohne technischen Hintergrund.
Abgesichert wird das Ganze durch eine vollständige Test-Suite, die die Ergebnisse des eigenen Solvers mit SciPys linprog abgleicht. Die Tests decken alle üblichen Fälle ab – zulässig, unzulässig, unbeschränkt, Gleichheitsnebenbedingungen usw.
Tech-Stack
Der Stack verbindet Pragmatismus mit Präzision:
- Sprache: Python 3.12 (Conda-kompatibel)
- Mathematik-Bibliotheken: NumPy, SciPy (zur Validierung), fractions (für den exakten Modus)
- UI: Streamlit (mehrseitige App), Plotly & Matplotlib für 2D-/3D-Diagramme, Pandas für Simplex-Tableaus
- LLM-Integration: Google Gemini über
google-genai, mit Verwaltung des API-Schlüssels in einer .env-Datei überpython-dotenv– Gemini wegen des kostenlosen Kontingents und der sehr guten Performance - Tests: Python unittest, Abgleich mit SciPys „highs“-Solver
- Entwicklungswerkzeuge: Git, pip, pre-commit (für Linting und Typprüfungen)
Installationsanleitung, Nutzungsbeispiele und die vollständige Codestruktur finden Sie im GitHub-Repository.
Herausforderungen
Einige Bereiche erforderten besondere Sorgfalt:
- Umformung in die Standardform: Gemischte Nebenbedingungen und negative rechte Seiten zu behandeln war mühsam und fehleranfällig.
- Aufbau der zwei Phasen: Phase I/II sauber umzusetzen, künstliche Variablen zu verwalten und korrektes Pivotieren sicherzustellen war alles andere als trivial.
- State-Management in Streamlit: Solver-Zustände, Diagramme und Oberfläche über Reruns und Interaktionen hinweg korrekt synchron zu halten, hat viele Iterationen gekostet.
- Umgang mit der LLM-Ausgabe: Konsistente, strukturierte Ausgaben vom LLM zu bekommen war fragil. Nötig waren Prompt-Tuning sowie Nachbearbeitungslogik, um die Ausgabe zu bereinigen und sicher auszuführen.
Was ich gelernt habe
- Tiefes Verständnis durch eigene Implementierung: Den Simplex- und den Karmarkar-Algorithmus von Grund auf zu implementieren, hat mein Verständnis der linearen Optimierung deutlich vertieft. Besonders aufschlussreich war der Übergang von Phase I zu Phase II im Simplexverfahren, weil er einen sorgfältigen Umgang mit Basiswechseln und das Erhalten der Zulässigkeit erfordert. Dabei habe ich gelernt, mathematische Konzepte noch besser in effizienten Code zu übersetzen – vor allem bei den Pivotoperationen und bei der Sicherstellung numerischer Stabilität.
- Interaktive Diagramme in Streamlit integrieren: Matplotlib und Plotly gemeinsam für Visualisierungen in der Streamlit-Oberfläche einzusetzen, brachte eigene Herausforderungen mit sich. Entscheidend war, dass die Diagramme interaktiv bleiben und auf Nutzereingaben reagieren, ohne unnötige Reruns oder Neuberechnungen. Dafür musste ich den Session State von Streamlit gezielt nutzen, um Zwischenergebnisse und Nutzereinstellungen zu speichern – so lassen sich Diagramme wie der zulässige Bereich oder die Sensitivitätsanalyse dynamisch aktualisieren, ohne die Anwendung neu zu starten.
- Das Session-Modell von Streamlit nutzen: Das Session-Modell und die UI-Komponenten von Streamlit sind mächtige Werkzeuge für interaktive Anwendungen. Sie erfordern aber eine disziplinierte Verwaltung, besonders in mehrseitigen Apps, damit der Session State konsistent aktualisiert und zwischen den Komponenten geteilt wird. Dazu gehörte, Session-Variablen sorgfältig zu initialisieren und zurückzusetzen, um ein nahtloses Nutzererlebnis zu gewährleisten.
- Validierung mit bewährten Solvern: Meine Implementierung gegen SciPys linprog zu testen, war entscheidend, um Grenzfälle zu identifizieren und die Genauigkeit sicherzustellen. Der Vergleich half, subtile Fehler früh zu finden – etwa Probleme mit der numerischen Genauigkeit oder Grenzfälle bei der Behandlung von Nebenbedingungen – und diente als Benchmark für die Performance und Korrektheit meiner Algorithmen.
Geplante Verbesserungen
Folgendes würde aus meiner Sicht künftig den größten Mehrwert bringen:
- Dualer Simplex: Wäre nützlich für Warmstarts und eine erweiterte Sensitivitätsanalyse.
- Sichere Codeausführung: Vom LLM erzeugter Code braucht eine ordentliche Sandbox – etwa einen entfernten Microservice.
- Exportoptionen: Nutzer sollen Ergebnisse als PDF-/LaTeX-Berichte oder als Datendateien (CSV/JSON) speichern können.
- Verbesserungen der Oberfläche: grafischer Editor für Nebenbedingungen, Benutzerkonten, gespeicherter Problemverlauf usw.
- DevOps: CI/CD-Pipeline (z. B. GitHub Actions + Docker), um Tests und Builds zu automatisieren.
- Erweiterte Analysen: Unterstützung für robuste Optimierung und LPs mit mehreren Zielfunktionen würde den analytischen Umfang erweitern.
- Implementierung von Branch and Bound für die ganzzahlige Optimierung.
- Implementierung eines Schnittebenenverfahrens für die ganzzahlige Optimierung.
Screenshots