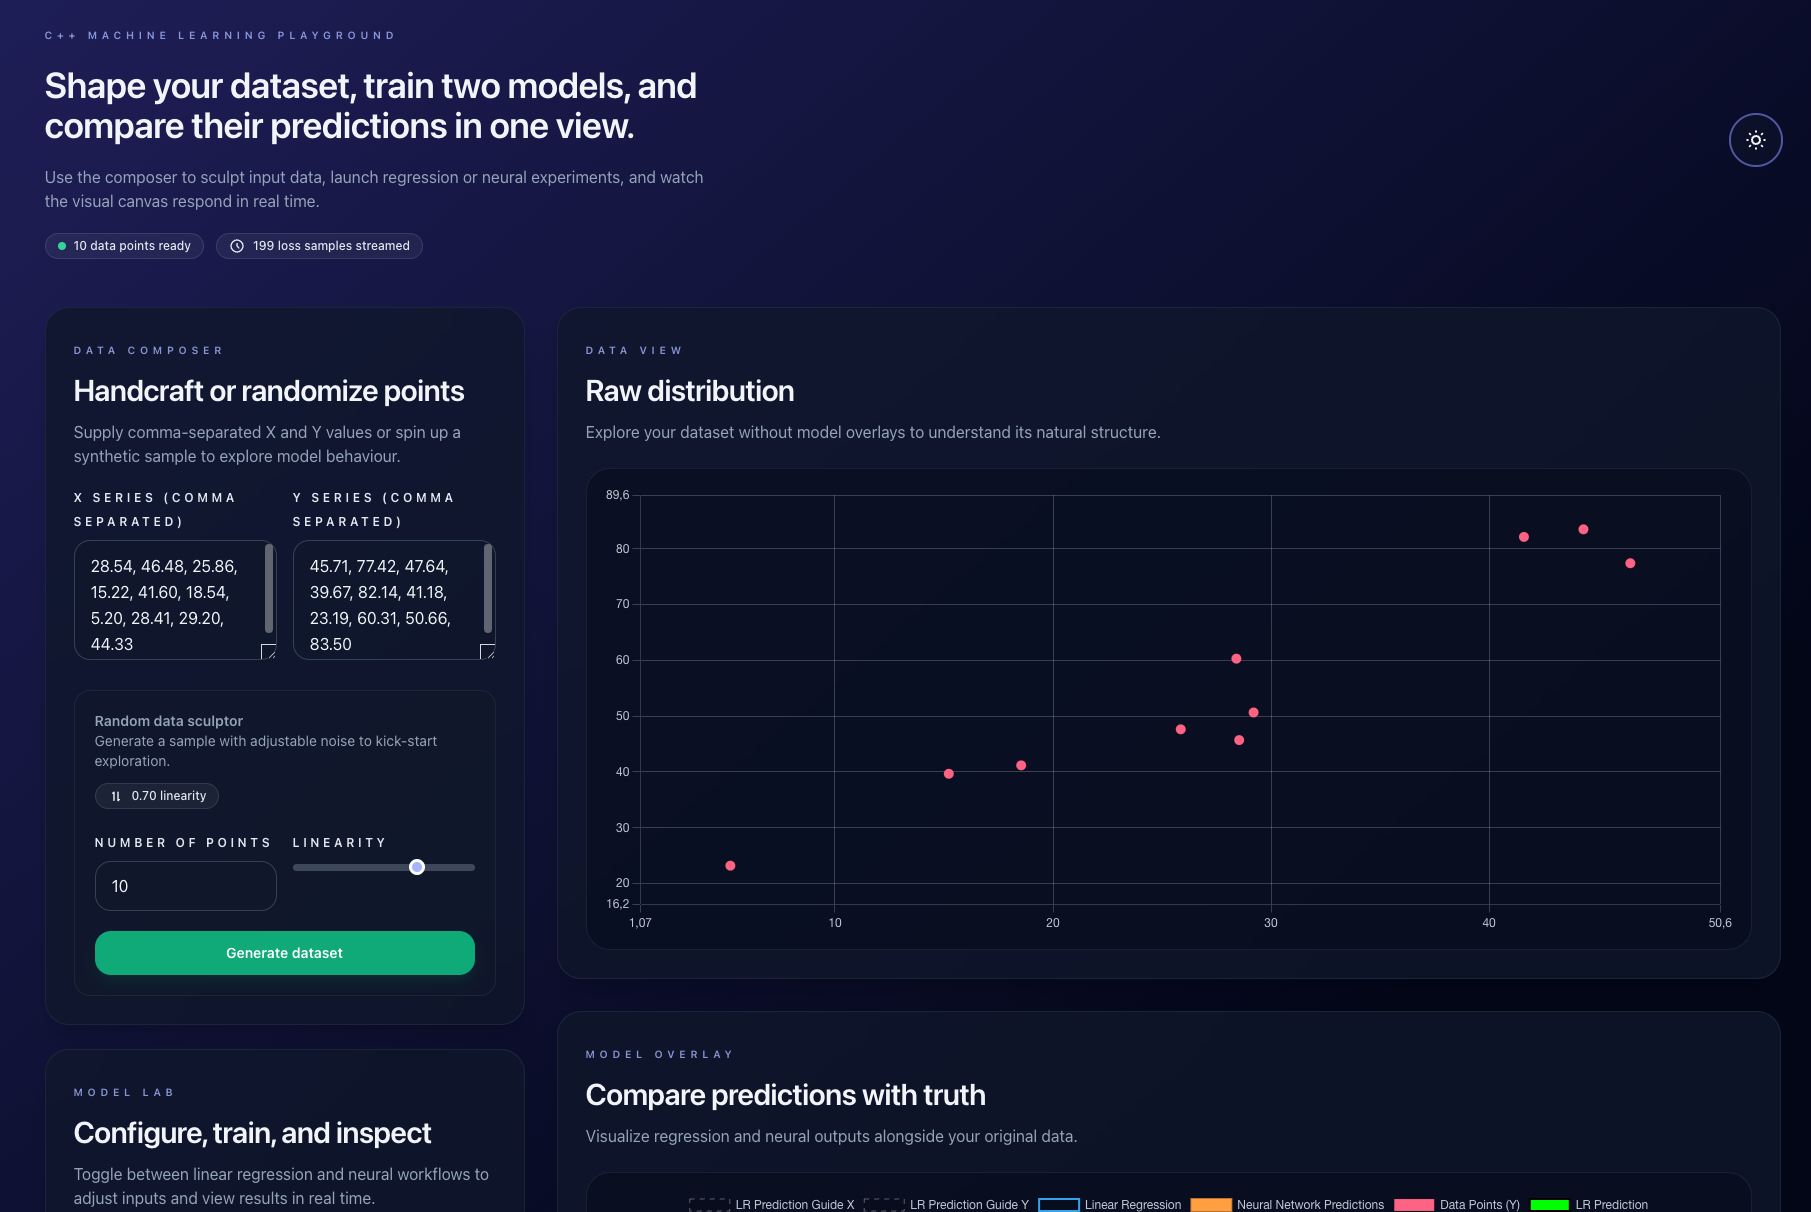
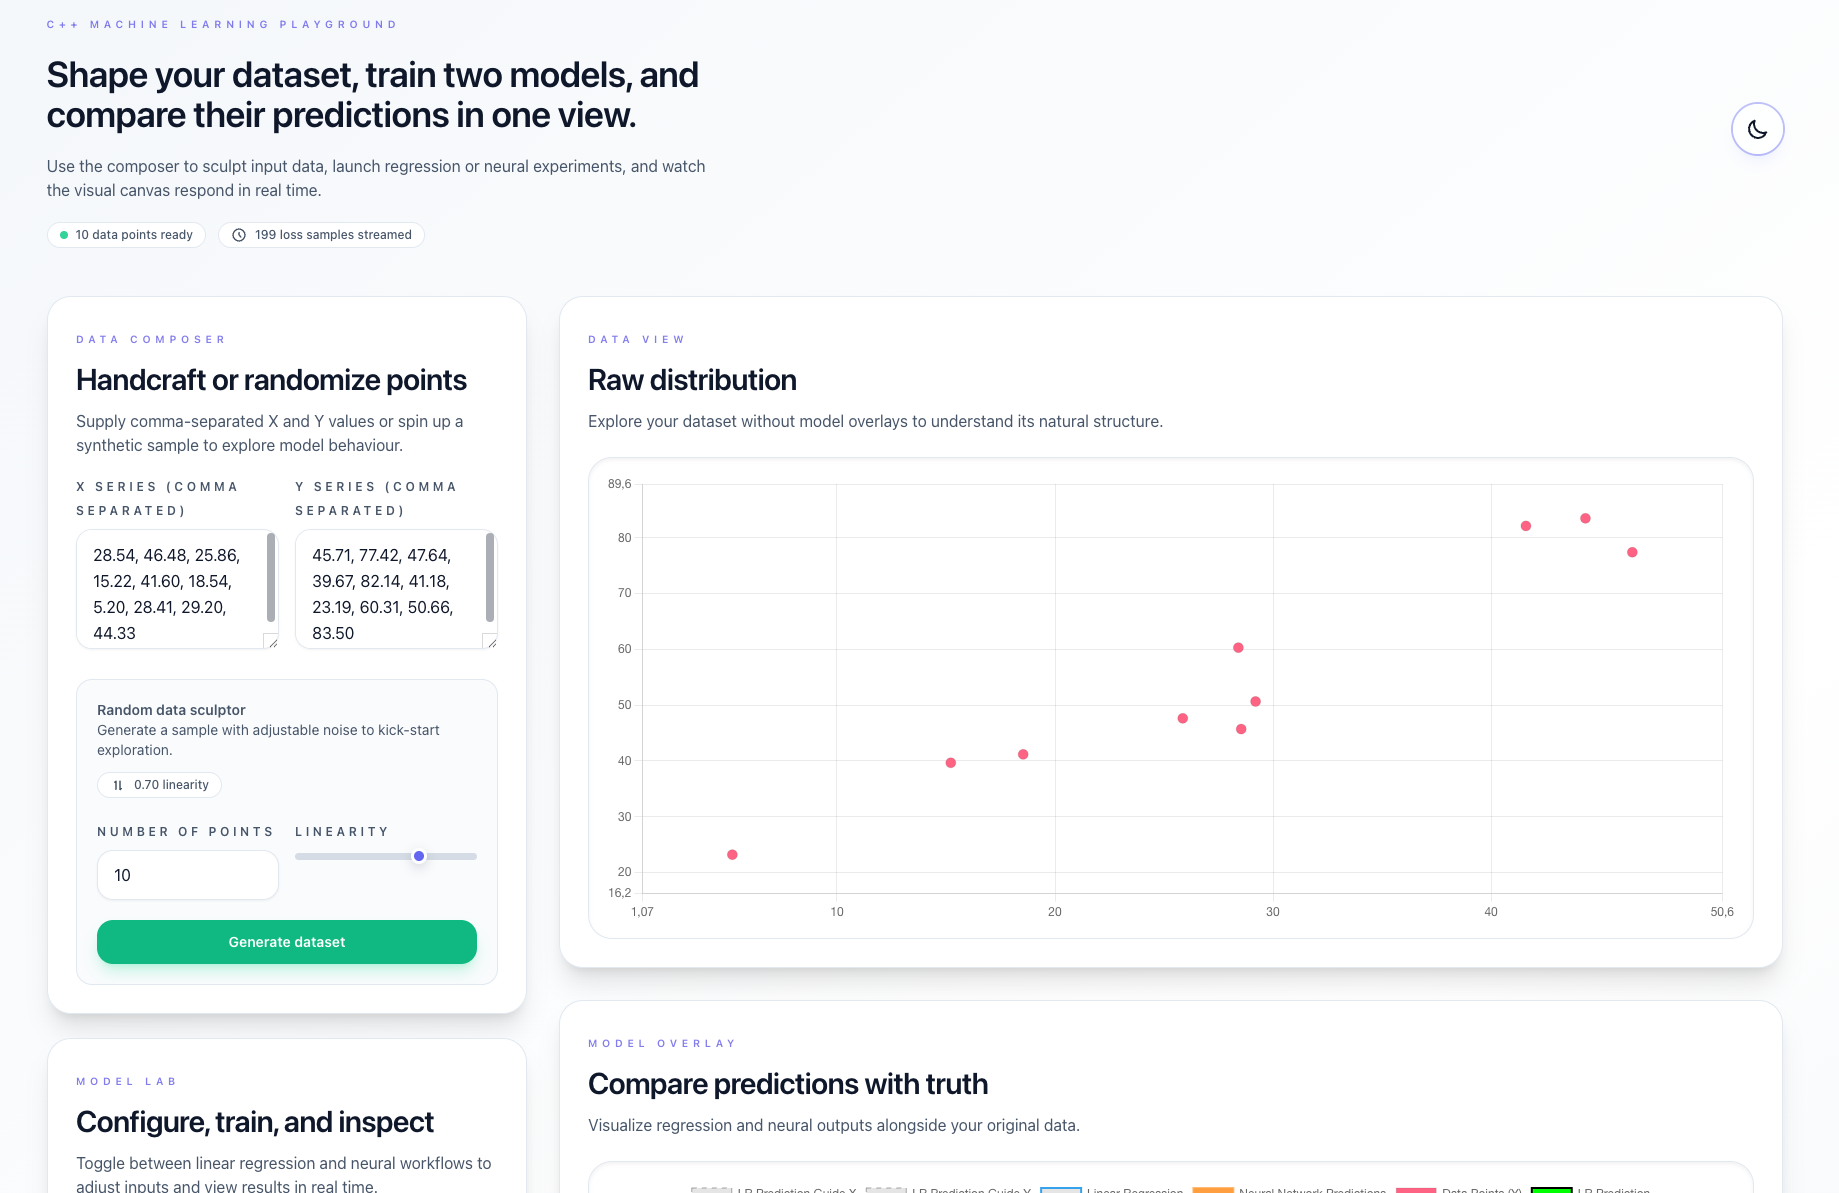
Lineare Regression & neuronales Netz in C++
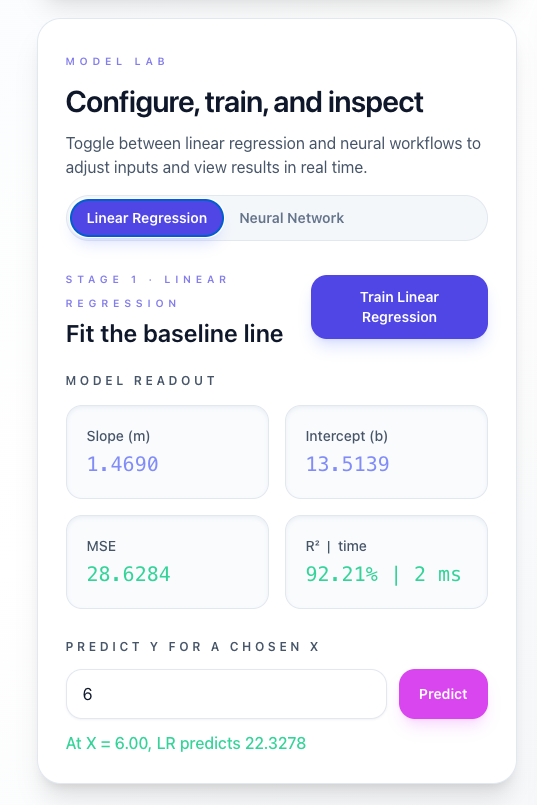
Eine Full-Stack-Anwendung zum Trainieren und Visualisieren eines linearen Regressionsmodells und eines Feedforward-Netzes – mit einer C++-Engine, einem Node.js-Backend und einem React-Frontend.
Problem
Machine-Learning-Bibliotheken verbergen die Mathematik. Ich wollte die Modelle selbst implementieren und das Training in Echtzeit beobachtbar machen.
Ansatz
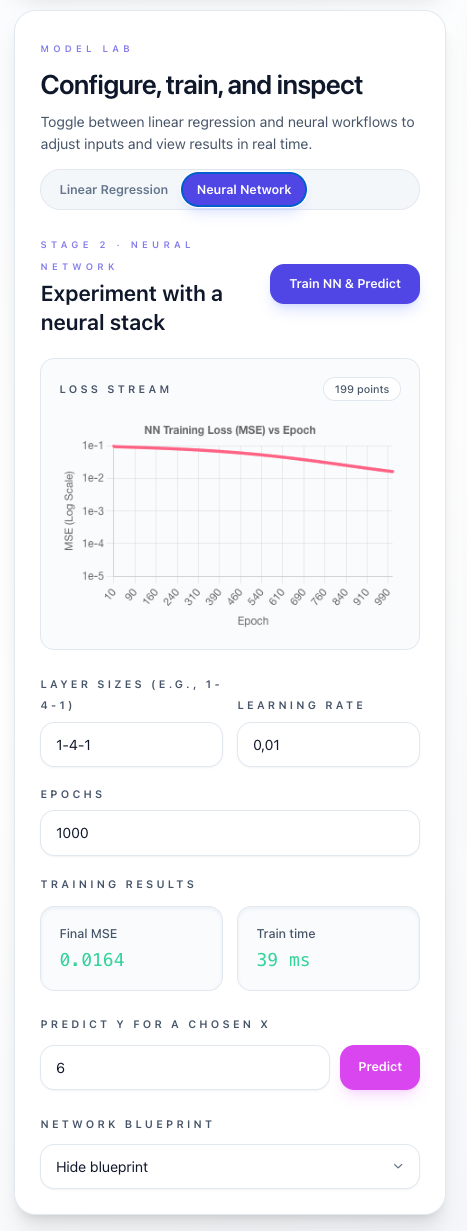
Ich habe eine analytische lineare Regression und ein konfigurierbares Feedforward-Netz mit Backpropagation in C++ geschrieben, die Engine über einen Node.js/Express-Server ausgeführt und den Trainingsfortschritt per WebSockets an ein React-Dashboard gestreamt.
Ergebnis
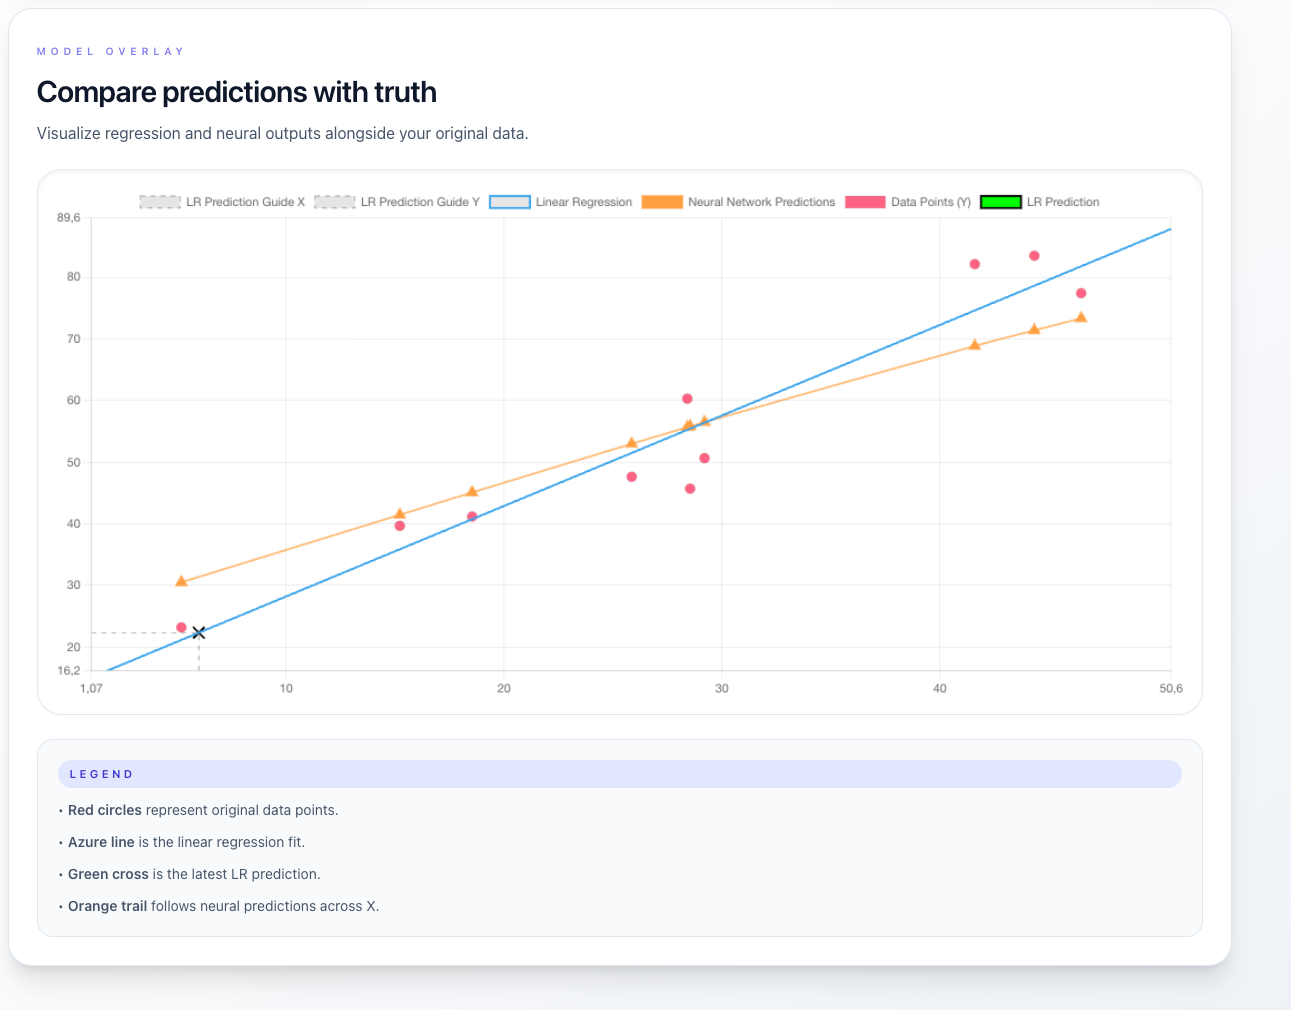
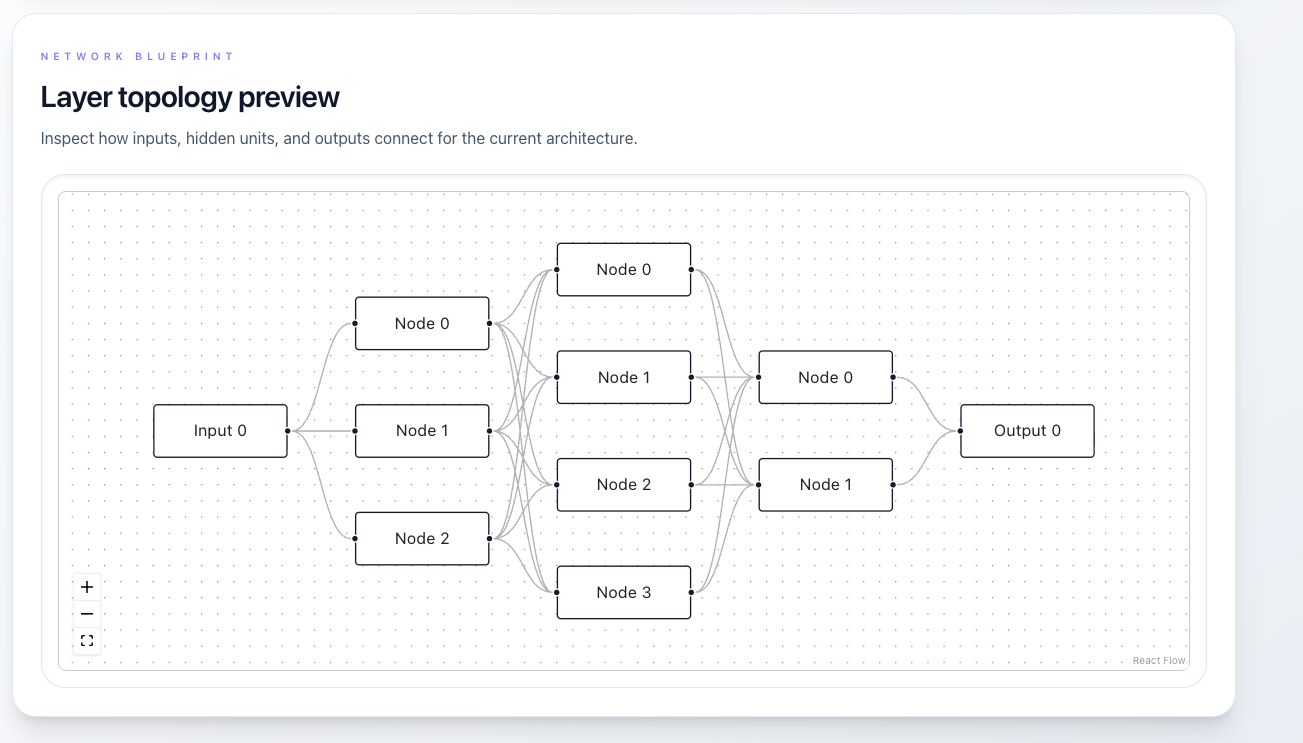
Trainings-Loss und Modellanpassung aktualisieren sich live im Browser – so lässt sich direkt sehen, wie Hyperparameter und Netzarchitektur die Konvergenz beeinflussen.
Überblick
Dieses Projekt verbindet leistungsstarke Berechnungen in C++ mit einer modernen Webanwendung und eignet sich damit sowohl für die Lehre als auch für schnelles Prototyping. Es umfasst eine analytische lineare Regression und ein anpassbares Feedforward-Netz, beide in C++11 implementiert und nahtlos in ein Node.js/Express-Backend eingebunden. Das mit React entwickelte Frontend nutzt REST-APIs und WebSockets, um Datenpunkte, Regressionsgeraden, Trainings-Loss und Vorhersagen dynamisch und in Echtzeit zu visualisieren.
Tech-Stack
C++-Engine
- Sprache: C++11
- Build-System: GNU Make
- Bibliotheken: STL, OpenMP (für optionale Parallelisierung)
- Features: Hochperformante mathematische Operationen, parallelisiertes Training
Backend-Server
- Laufzeitumgebung: Node.js
- Framework: Express für REST-API-Endpunkte
- Kommunikation:
- WebSocket (ws) für Live-Datenstreaming
- child_process.spawn zum Ausführen des C++-Binaries
- Features: Verbindet die C++-Berechnungen mit dem Frontend und streamt Trainingsdaten in Echtzeit
Frontend-Client
- Framework: React (über create-react-app)
- Styling: Tailwind CSS mit DaisyUI-Komponenten
- Visualisierung: Chart.js für interaktive Datenvisualisierung
- Kommunikation: WebSocket-API für Echtzeit-Updates
- Features: Interaktive Oberfläche für Dateneingabe, Modellkonfiguration und Ergebnisanzeige
Build- & Entwicklungswerkzeuge
- Build-Tools: GNU Make, npm, Node.js
- Plattformunterstützung: Plattformübergreifend (Windows über MinGW, macOS, Linux)
- Entwicklung: Hot Reloading für schnelle Iterationen
Installationsanleitung, Nutzungsbeispiele und die vollständige Codestruktur finden Sie im GitHub-Repository.
Herausforderungen
Im Laufe des Projekts bin ich auf drei große Herausforderungen gestoßen, die mich dazu gebracht haben, mein Verständnis von C++ und Full-Stack-JavaScript-Entwicklung zu vertiefen. Im Folgenden beschreibe ich jede Herausforderung, wie ich sie in meiner Implementierung gelöst habe, warum ich mich für diesen Ansatz entschieden habe und wie ich ihn künftig verbessern könnte.
1. Brücke zwischen C++ und Node.js
Ich musste hochperformanten C++-Code (sowohl einen analytischen Solver für die lineare Regression als auch ein eigenes neuronales Netz mit Backpropagation) aus einem Node.js-Backend heraus ausführen, ohne dabei Produktivität oder Wartbarkeit zu opfern.
Umgesetzte Lösung
- Ich habe meine C++-Logik zu eigenständigen ausführbaren Dateien kompiliert (
linear_regression_appund das kombiniertemain_serverfür LR und NN). - In
server/server.jsstarte ich mit Nodeschild_process.spawndas passende C++-Binary mit Befehlen wielr_trainodernn_train_predict. - Die Daten werden über
stdinals einfache kommagetrennte Zeilen übergeben (z. B.1,2,3,4\n2,4,6,8\n), die Ausgabe erfolgt zeilenweise im Formatkey=value. - Eine Hilfsfunktion
parseCppLine(line)zerlegt jede Zeile in{ type: 'loss_update', epoch, mse }oder{ type: 'final_stat', key, value }, die ich dann in JSON-Nachrichten für HTTP-Antworten und WebSocket-Broadcasts umwandle.
Warum dieser Ansatz
- Einfachheit: Durch Standard-I/O und ein textbasiertes Protokoll braucht die C++-Seite keinerlei Abhängigkeiten über die STL hinaus.
- Entkopplung: C++ bleibt eine reine Konsolenanwendung; Node.js übernimmt die gesamte Orchestrierung und das Parsen in JavaScript.
- Portabilität: Weder N-API noch die Pflege nativer Addons sind nötig; dieselben Binaries lassen sich aus jeder Sprache oder Umgebung aufrufen, die Prozesse starten kann.
Künftige Verbesserungen
- Das zeilenbasierte Protokoll durch ein robusteres Serialisierungsformat ersetzen (z. B. JSON oder Protocol Buffers), um Grenzfälle beim Parsen zu vermeiden.
- Sobald der Prototyp stabil ist, ein echtes Node-Addon (über N-API) schreiben, um eine engere Integration und geringere Latenz zu erreichen.
2. Loss-Streaming in Echtzeit über WebSockets
Während des Trainings des neuronalen Netzes gebe ich nach jeder Epoche den Loss aus. Bei kleinen Datensätzen oder vielen Epochen überflutet das den WebSocket-Kanal und führt zu einer trägen Oberfläche oder sogar zu Pufferüberläufen im Browser.
Umgesetzte Lösung
- Jedes Mal, wenn C++ eine Zeile wie
epoch=42,mse=0.1234schreibt, sendetserver.jsein Objekt{ type: 'loss_update', epoch, mse }an alle verbundenen WebSocket-Clients. - Im React-Frontend (
App.js) sammle ich eingehende Updates in einem lokalen Batch (lossUpdateBatchRef). - Mit
lodash.throttlerufe ich eine Batch-Update-Funktion höchstens einmal alle 150 ms auf. Diese Funktion-
führt neue Punkte (ohne Duplikate) in den React-State zusammen,
-
leert den Batch,
-
ruft direkt
chartRef.current.update('none')auf der Chart.js-Instanz auf, um ohne Animation neu zu zeichnen.
-
- Wenn das Endergebnis oder ein Fehler eintrifft (
type: 'final_result'/type: 'error'), rufe ichflush()auf der gedrosselten Funktion auf, um verbleibende Batches sofort zu verarbeiten.
Warum dieser Ansatz
- Performance: Das Drosseln verhindert, dass React Hunderte oder Tausende Diagrammpunkte pro Sekunde neu rendert.
- Reaktionsfähigkeit: Manuelle Diagramm-Updates (
'none') sparen den Animationsaufwand und halten den Graphen bei minimalem Flackern synchron. - Zuverlässigkeit: Batching + Flush stellt sicher, dass keine Nachrichten verloren gehen – selbst wenn sie schneller eintreffen als das Drosselintervall.
Künftige Verbesserungen
- Serverseitiges Puffern oder ein dynamisches
report_every_n_epochs(über die API konfigurierbar) einführen, um den Netzwerkverkehr zu reduzieren. - Visuelles Feedback (z. B. einen Fortschrittsbalken) anbieten, damit Nutzer sehen, dass das Training weiterläuft, auch wenn gerade keine Loss-Updates kommen.
- Binäre Protokolle über WebSocket (z. B. MessagePack) ausprobieren, um den Overhead weiter zu senken.
3. Korrektes neuronales Netz und Backpropagation in C++
Einen vollwertigen Backpropagation-Algorithmus von Grund auf in C++ zu schreiben – mit flexiblen Schichtgrößen, sicherer Matrix-/Vektorarithmetik und regelmäßiger Loss-Ausgabe – ist ein anspruchsvolles Unterfangen.
Umgesetzte Lösung
- Ich habe eine Klasse
NeuralNetwork(neural_network.h/.cpp) entwickelt, die:-
layer_sizes_, einen Vektor von Gewichtsmatrizen sowie Bias-Vektoren speichert. -
die Gewichte mit einer einfachen Skalierung im Stil der He-Initialisierung (
±0.5/√n) und die Biases mit kleinen positiven Werten initialisiert. -
forward_passimplementiert, um gewichtete Summen (z) zu berechnen und auf den verborgenen Schichtensigmoidanzuwenden, auf der Ausgabeschicht die Identität. -
sowohl die Werte vor der Aktivierung (
layer_inputs_) als auch danach (layer_outputs_) speichert, um die Gradientenberechnung zu vereinfachen. -
backpropagateimplementiert, indem sie-
das Delta der Ausgabeschicht als
(ŷ – y)berechnet, -
es über transponierte Gewichtsmultiplikation plus
sigmoid_derivative(z)durch jede verborgene Schicht zurückpropagiert, -
die Gewichte (
W ← W – η ⋅ δ⋅aᵀ) und Biases per stochastischem Gradientenabstieg aktualisiert.
-
-
train_for_epochs(inputs, targets, epochs)bereitstellt, das die Daten in jeder Epoche mischt,backpropagateauf jedes Beispiel anwendet undepoch=<n>,mse=<value>ausgibt, sobald(epoch+1)%report_every_n_epochs==0gilt, sowie in der letzten Epoche. -
nach dem Training einen flachen Vektor mit den finalen Vorhersagen für alle Eingaben zurückgibt, sodass der Aufrufer
final_mse,training_time_msundnn_predictions=…berechnen und ausgeben kann.
-
Warum dieser Ansatz
- Klarheit: Die Trennung von Vorwärts- und Rückwärtslogik in klar abgegrenzte Methoden erleichtert das Debuggen jeder einzelnen Stufe.
- Wiederverwendbarkeit: Dieselbe Methode
train_for_epochsübernimmt sowohl die Loss-Ausgabe (für das Streaming) als auch die Ausgabe der finalen Vorhersagen. - Kontrolle: Durch eigene Vektor-/Matrixroutinen kann ich die Korrektheit sicherstellen, bevor ich eine externe Abhängigkeit für lineare Algebra einführe.
Künftige Verbesserungen
- Den selbst geschriebenen Matrix-/Vektorcode durch eine hochperformante Bibliothek (z. B. Eigen oder BLAS) ersetzen, um große Netze zu beschleunigen.
- Weitere Aktivierungsfunktionen (ReLU, tanh) und Loss-Funktionen (Kreuzentropie) unterstützen, um das Einsatzspektrum zu erweitern.
- Mini-Batch-Gradientenabstieg, Momentum und adaptive Lernraten-Scheduler ergänzen, um die Konvergenz auf größeren Datensätzen zu verbessern.
Die Arbeit an diesen Herausforderungen hat meine Fähigkeiten in hardwarenahem C++ deutlich verbessert (vor allem beim Entwurf und Debuggen des Backpropagation-Algorithmus) – ebenso wie meine Fähigkeit, eine Full-Stack-Pipeline zu entwerfen, die nativen Code zu einem flüssigen Web-Erlebnis in Echtzeit verbindet.
Was ich gelernt habe
Der Aufbau dieser durchgängigen C++ ↔ Node.js-Pipeline und der Demo mit live gestreamtem Training eines neuronalen Netzes hat mir wertvolle Erkenntnisse gebracht – sowohl in der hardwarenahen Systemprogrammierung als auch in der übergeordneten Webarchitektur:
-
Prozesskommunikation & Protokolldesign
-
Ich bin jetzt sicher im Umgang mit
child_process.spawnin Node.js, um native Binaries zu starten, Daten instdinzu leiten und sowohlstdoutals auchstderrals Streaming-Events zu lesen. -
Ein minimales Textprotokoll zu entwerfen – zeilenweise
key=value-Paare aus C++ ausgeben und sie in JavaScript mit einer einzigen Hilfsfunktion (parseCppLine) parsen – erwies sich als robust und leicht zu debuggen. -
Ich habe gelernt, mich gegen Grenzfälle abzusichern: den stdin-Stream von C++ immer zu beenden (
cppProcess.stdin.end()), vor dem Schreiben von HTTP-Antwortenres.headersSentzu prüfen und Exit-Codes ungleich null oder Parse-Fehler sauber zu behandeln.
-
-
Echtzeit-Streaming über WebSockets
-
Die Integration der
ws-Bibliothek auf dem Server und eines nativenWebSocketin React hat mir die Herausforderungen hochfrequenter Updates aus erster Hand gezeigt. -
Ich habe festgestellt, dass ungedrosselte Nachrichten pro Epoche den Browser überfordern. Für ein flüssiges Rendering der Diagramme ist es daher entscheidend, sie in einer
useRef-Queue zu bündeln und den React-State mitlodash.throttle(150 ms) zu aktualisieren. -
Durch den direkten Aufruf von
chartRef.current.update('none')auf der Chart.js-Instanz habe ich gelernt, die Datenaufnahme vom animierten Neuzeichnen zu entkoppeln – so bleibt die Oberfläche auch unter Last reaktionsschnell. -
Sauberes Aufräumen beim Unmount –
scheduleProcessLossBatch.cancel()aufrufen, Sockets imuseEffect-Cleanup schließen und Batches leeren – verhinderte subtile Speicherlecks und verwaiste Callbacks.
-
-
Backpropagation in C++ implementieren
-
Eine vollständige Klasse
NeuralNetworkvon Grund auf zu schreiben, hat mein Verständnis von Forward Passes, dem Speichern der Eingaben vor der Aktivierung (z) und der Ausgaben nach der Aktivierung (a) sowie der schichtweisen Berechnung der Deltas gefestigt. -
Ich habe meine C++-Kenntnisse geschärft: • Ausnahmesicheres Parsen mit
std::strtodund gründliche Fehlerprüfungen inparseVectorundparseLayerSizes. • Zufällige Initialisierung der Gewichte mitstd::mt19937und skalierten Gleichverteilungen. • Präzise Zeitmessung mit<chrono>, umtraining_time_msauszugeben. -
Die Trennung von Algorithmus (
train_for_epochs) und I/O (main_server.cpp) hat beide Seiten leichter test- und wartbar gemacht. Inzwischen schätze ich die Disziplin, bei ungültigen Matrixdimensionen eine Exception zu werfen und jede Parse-Exception auf oberster Ebene abzufangen.
-
-
Full-Stack-Architektur & Tooling
-
Ich habe Sicherheit darin gewonnen, eine JavaScript-REST-/WebSocket-Schicht (Express + ws) mit einem React-Frontend (react-chartjs-2, reactflow) und einer numerischen C++-Engine zu verbinden. Eine klare Trennung der Zuständigkeiten hielt jede Komponente fokussiert – Node.js orchestriert die Prozesse und bedient HTTP-/WebSocket-Clients, React verwaltet State und Darstellung, und C++ übernimmt die Rechenarbeit.
-
Detailliertes Logging wurde zu meinem besten Freund: C++-stdout/stderr in Chunks an die Node-Konsole streamen, strukturierte Logs ausgeben (
LR Train C++ Stdout Chunk,WebSocket message received) und Fehler früh sichtbar machen – das hat das Debugging über mehrere Sprachen hinweg beherrschbar gemacht. -
Ich habe Best Practices bei Eingabevalidierung (in JS und C++), Fehlerweitergabe und defensivem Aufräumen gefestigt – Fähigkeiten, die sich in jedem großen System auszahlen.
-
Nächste Schritte
- Das IPC-Protokoll standardisieren (z. B. JSON oder Protocol Buffers über stdin/stdout), um improvisiertes Parsen zu vermeiden.
- Sobald der Prototyp stabil ist, mit einem nativen Node.js-Addon (N-API) für eine engere C++-Integration mit geringerer Latenz experimentieren.
- Den Code des neuronalen Netzes um Mini-Batch-Training, Momentum und alternative Aktivierungsfunktionen erweitern und ihn in einem Benchmark mit bestehenden Bibliotheken hinsichtlich Performance und Genauigkeit vergleichen.
Geplante Verbesserungen
-
GPU-Beschleunigung: CUDA-Kernels für das parallele Training neuronaler Netze implementieren – bei großen Probleminstanzen potenziell mit einer 10- bis 100-fachen Beschleunigung.
-
Weitere Optimierer: Weitere Optimierungsalgorithmen (z. B. Adam, RMSprop) implementieren, um Konvergenz und Performance zu verbessern.
-
Weitere Aktivierungsfunktionen: Weitere Aktivierungsfunktionen (z. B. ReLU, tanh) implementieren, um die Performance zu verbessern.
Screenshots