Wetterbildklassifikation mit einem CNN
Ein Convolutional Neural Network in PyTorch, das 11 Wetterphänomene auf Fotos klassifiziert – mit Hyperparameter-Tuning per Optuna und einer vollständigen Evaluations-Pipeline.
Problem
Wetterlagen wie Nebel, Frost, Hagel oder Raureif anhand von Fotos zu klassifizieren, obwohl sich mehrere Klassen optisch stark ähneln.
Ansatz
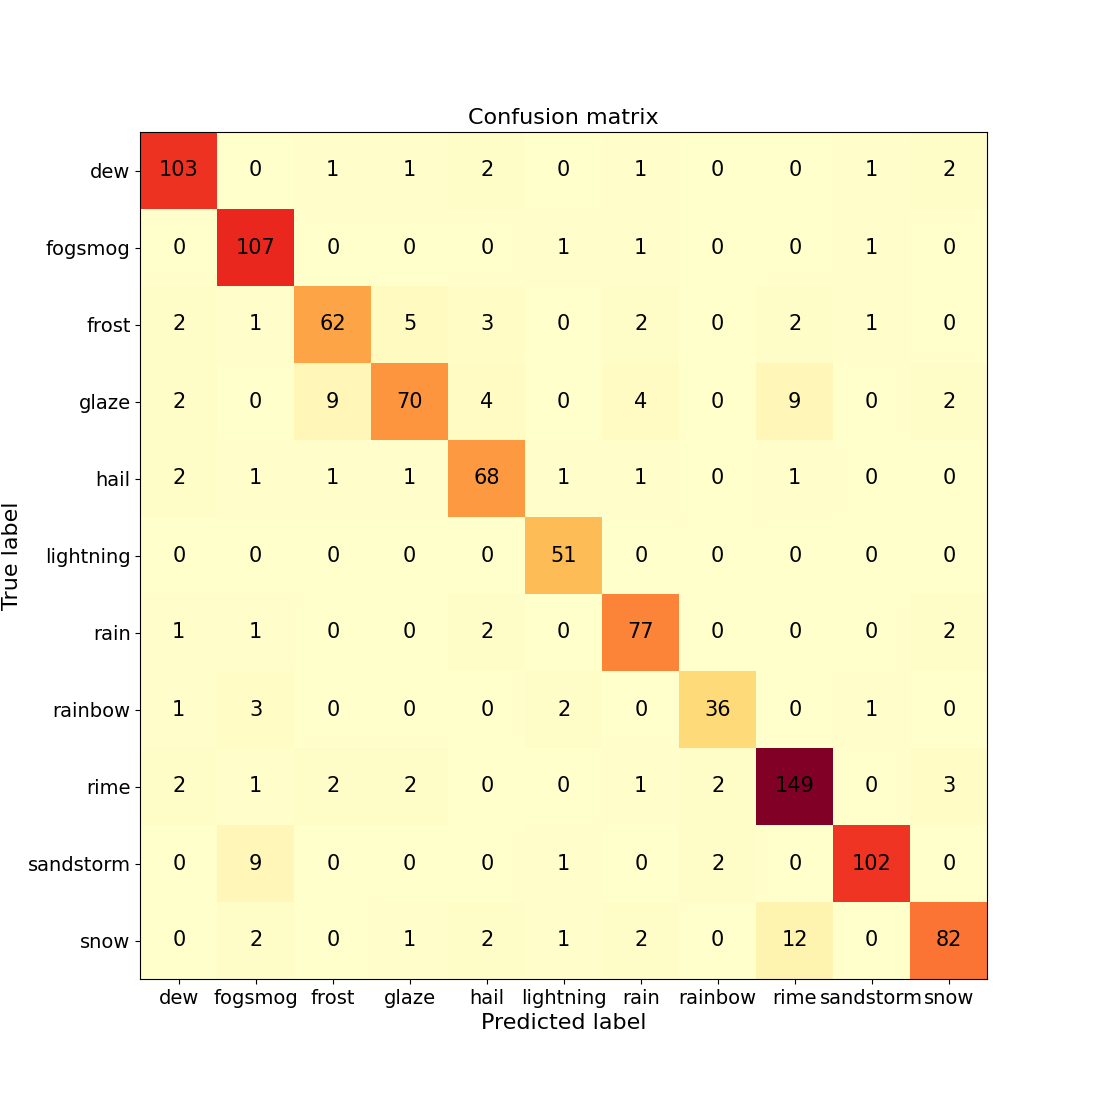
Ich habe ein eigenes faltendes neuronales Netz in PyTorch entwickelt, Lernrate und Weight Decay mit Optuna optimiert und das Modell mit gewichtetem F1-Score, Precision, Recall und einer Konfusionsmatrix evaluiert.
Ergebnis
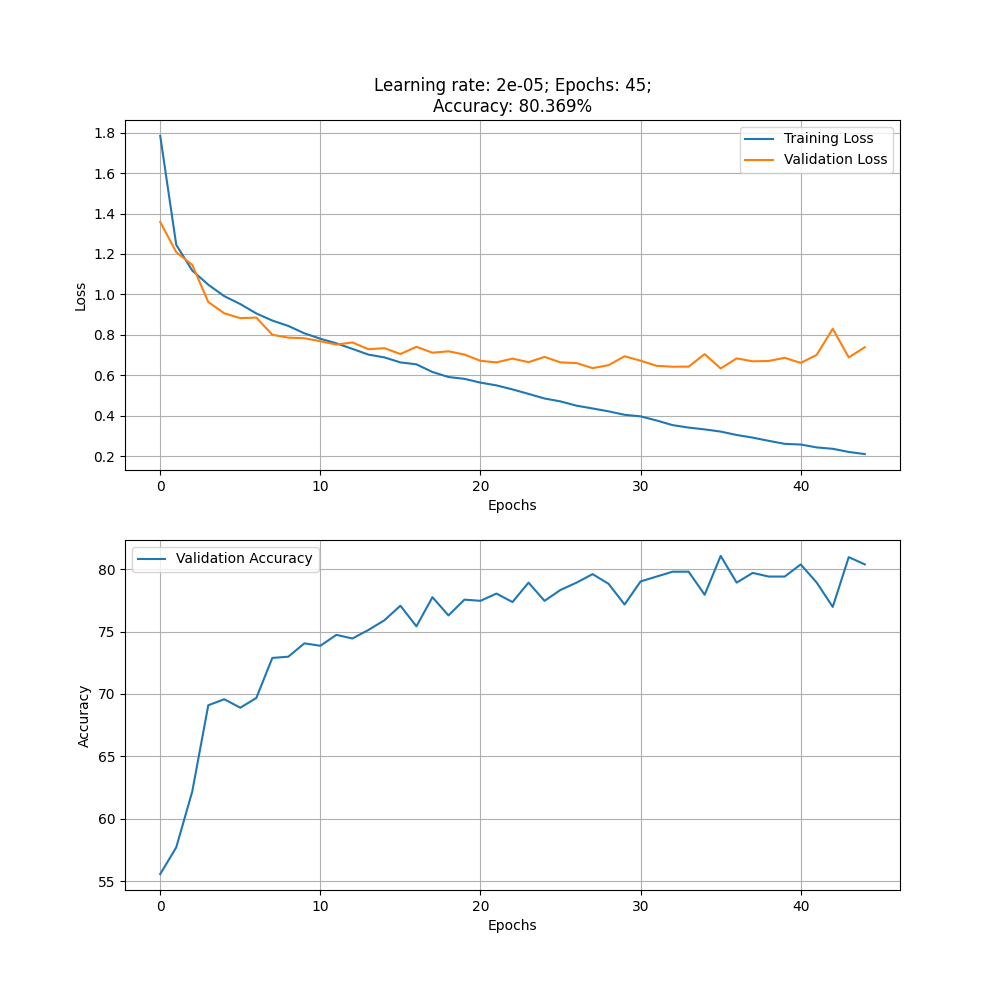
Eine reproduzierbare Pipeline vom Training bis zur Batch-Vorhersage; Experiment-Artefakte wie Loss-Kurven und Konfusionsmatrizen werden zum Vergleich gespeichert.
Überblick
Dieses Projekt umfasst eine End-to-End-Pipeline zur Bildklassifikation, die 11 verschiedene Wetterphänomene (Tau, Nebel/Smog, Frost, Glatteis, Hagel, Blitz, Regen, Regenbogen, Raureif, Sandsturm, Schnee) mit einem eigenen Convolutional Neural Network (CNN) in PyTorch erkennt. Sie bietet:
- Ein Trainings-Skript (
src/training/train_model.py), das ein dreischichtiges ConvNet mit konfigurierbarer Bildskalierung und Logging implementiert. - Ein Modul zur Hyperparameter-Optimierung mit Optuna
(
src/training/optimize_hyperparameters.py), das Lernrate, Weight Decay und weitere Parameter in einem Small- und einem Large-Modus optimiert und die Trials indb.sqlite3speichert. - Ein Evaluations-Tool (
src/evaluation/evaluation.py), das gewichteten F1-Score, Precision und Recall berechnet, einen Classification Report ausgibt und einen Plot der Konfusionsmatrix speichert. - Eine Vorhersage-CLI (
src/prediction/predict.py) für die Batch-Inferenz auf neuen Bildern mit dem trainierten Modell. - Hilfskomponenten unter
src/utils/zum Laden und Aufteilen der Daten (Train/Val/Test), zur Analyse der Klassenverteilung und zur Visualisierung der Modellarchitektur (mittorchview). - Einen Ordner
experiments/mit Loss-Kurven, Konfusionsmatrizen und weiteren Artefakten für die Reproduzierbarkeit.
Tech-Stack
- Sprache & Umgebung: Python 3.9.13 (Conda), PyTorch 2.1.2 & Torchvision 0.16.2
- Daten & Transformationen:
torchvision.datasets.ImageFolder, eigenesWeatherDataset,torch.utils.data.DataLoader - Hyperparameter-Tuning: Optuna 3.6.1 mit SQLite-Backend &
optuna-dashboard - Visualisierung: Matplotlib für Loss-Kurven & Tortendiagramme,
torchviewfür Modellgraphen - Evaluation: scikit-learn (classification_report, confusion_matrix), tabulate für CLI-Tabellen
- Logging & CLI: structlog, argparse, tqdm für Fortschrittsbalken
- Entwicklungswerkzeuge: Git, Conda (über
environment.yml),requierements.txt(pip-Lockfile)
Installationsanleitung, Nutzungsbeispiele und die vollständige Codestruktur finden Sie im GitHub-Repository.
Herausforderungen
1. Ein CNN in PyTorch von Grund auf entwickeln
Umgesetzte Lösung
- Die Klasse
WeatherClassifierentworfen: modulare Methoden_initialize_layers&_setup_classifier - Die Flatten-Größe dynamisch über einen Dummy-Input-Tensor berechnet
- Den Transfer des Modells auf das Device sowie Verbosity-Flags für detailliertes tabellarisches Logging umgesetzt
Warum dieser Ansatz
- Übersichtlichkeit & Debugbarkeit: Initialisierung der Schichten und Aufbau des Classifiers sind entkoppelt, sodass sich Zwischen-Shapes leichter prüfen lassen
- Flexibilität: Kanalanzahlen, Dropout-Raten und Aktivierungsfunktionen lassen sich leicht anpassen
Künftige Verbesserungen
- Residual- oder Depthwise-Separable-Blöcke für mehr Effizienz einbauen
- Transfer Learning (z. B. ResNet, EfficientNet) nutzen, um bei begrenzten Daten schneller zu konvergieren
- Mixed-Precision-Training (
torch.cuda.amp) ergänzen, um die RTX 4070 Ti voll auszureizen
2. Hyperparameter-Optimierung mit begrenzten Ressourcen
Umgesetzte Lösung
- Optuna eingesetzt, um Lernraten, Weight Decay, Batch-Größen und architekturbezogene Hyperparameter zu optimieren
- Einen „Small“-Modus (schneller Sweep über lr/wd) und einen „Large“-Modus (vollständige Suche) getrennt, um die GPU-Zeit im Griff zu behalten
- Trials in
db.sqlite3gespeichert und die interaktive Auswertung überoptuna-dashboardermöglicht
Warum dieser Ansatz
- Effizienz: Fokussierte Suchen vermeiden verschwendete GPU-Zyklen
- Reproduzierbarkeit: Dank SQLite-Speicherung lassen sich Studien fortsetzen oder teilen
- Transparenz: Die CLI gibt die besten Parameter in einer übersichtlichen Tabelle aus
Künftige Verbesserungen
- Optuna-Pruning integrieren, um schwache Trials frühzeitig abzubrechen
- Multi-Objective-Studien umsetzen (Accuracy vs. Trainingsgeschwindigkeit)
- Batch-Größen anhand von Echtzeit-Profiling des GPU-Speichers automatisch skalieren
Was ich gelernt habe
- Ein mathematisches CNN-Design in effiziente PyTorch-Module und Trainingsschleifen zu übersetzen.
- Bilder vorzuverarbeiten und zu analysieren.
- Optuna für skalierbare Hyperparameter-Suchen zu integrieren und Studien in SQLite zu speichern.
- Detaillierte Evaluationsskripte zu schreiben, die sowohl CLI-Tabellen als auch Plots in Publikationsqualität ausgeben.
Geplante Verbesserungen
- Eine formale Test-Suite (Unit- & Integrationstests) mit CI (GitHub Actions) zur automatisierten Validierung ergänzen. Generalisierung.
- Eine fortgeschrittenere Modellarchitektur wie ResNet oder AlexNet verwenden.
- Mit Transfer Learning (ResNet-/MobileNet-Backbones) experimentieren, um Accuracy und Geschwindigkeit zu steigern.
- Eine Web-UI mit Streamlit oder Flask für das interaktive Hochladen von Bildern & die Vorhersage bereitstellen.
Screenshots